P416 语言基础与数据平面编程
P4 全称是 Programming Protocol-independent Packet Processors,是一种网络编程语言,可以指定数据平面如何处理数据包。
本文依据正式发布的 P416 v1.2.5 语言规范整理。章节号按本文的学习顺序编排,引用规范时另行注明对应章节。语言规则、目标架构和编译器支持范围需要分开理解,同一份程序能否运行还取决于目标设备的资源和能力。
P4 描述解析器、表、动作和报文重组逻辑。端口、队列、寄存器等能力由架构提供,运行时管理表项则由 P4Runtime 等控制接口完成。文中的多数代码用于说明局部语法,需要放入相应的解析器或控制块,并补齐依赖的类型。标为错误的代码用于说明限制。
1 安装
这里使用社区维护的 p4-guide 安装脚本,安装 p4c、BMv2 等实验工具。它不是语言规范的一部分。
- 准备 Ubuntu 20.04、22.04 或 24.04。这里列出的是该版本脚本支持的 Ubuntu 版本,不能直接推断所有更新版本都兼容。
- 在用户主目录执行下面的命令。脚本会下载并编译依赖,安装过程可能较长。
#!/usr/bin/env bash
set -euo pipefail

cd "$HOME"
sudo apt update
sudo apt install -y git
git clone https://github.com/jafingerhut/p4-guide.git
git -C p4-guide checkout f1d4ea6df52c1d8847c38ab18d5979dc2538124f
./p4-guide/bin/install-p4dev-v8.sh |& tee log.txt- 新开 Bash 后,执行
source "$HOME/p4setup.bash"加载脚本生成的环境配置,也可以把它加入~/.bashrc。这一步用于启用 Python 虚拟环境和工具路径,并非 P4 语言本身的要求。 - 执行
p4c --version检查编译器是否可用。记录编译器版本和安装日志,便于复现实验。
2 语法
预处理
P4 编译器支持 C 预处理器的部分功能:
#define#undef#if#else#endif#ifdef#ifndef#elif#include
与 C 类似,#include 可以在 "" 或者 <> 中指定文件名:
#include <system_file>
#include "user_file"
核心库
所有 P4 程序必须导入核心库:
#include <core.p4>标识符
P4 标识符由字母、数字、下划线组成,不能以数字开头。单个下划线 _ 表示不关心的值,其含义取决于上下文。例如,它可以忽略输出参数,也可以在 select 中表示全集。
下表显示了所有 P4 保留关键字:
abstract        action          apply           bit
bool            const           control         default
else            enum            error           extern
exit            false           header          header_union
if              in              inout           int
list            match_kind      out             package
parser          priority        return          select
state           string          struct          switch
table           this            transition      true
tuple           type            typedef         value_set
varbit          verify          void
priority
priority 用于 entries 表项的优先级声明,属于上下文关键字。在没有歧义的位置仍可作名称使用,类似的还有 key、actions、entries 等。参见规范 §6.4.1。
命名约定
以下是规范建议的风格,不是编译器强制要求:
- 内置类型全部小写,例如:
int<16> - 自定义类型首字母大写,例如:
IPv4Address - 类型变量全部大写,例如:
parser P<H, IH>() - 变量首字母小写,例如:
ipv4header - 常量全部大写,例如:
CPU_PORT - 错误和枚举使用驼峰形式,例如:
PacketTooShort
注释
- 单行注释:
// 注释内容 - 多行注释:
/* 注释内容 */
字面量类型
布尔
true 和 false 。
整数
整数字面量的数字部分是非负整数。负值通常由一元负号构成,例如 -5。可以在数字前添加前缀指定进制:
- 十六进制:
0x或者0X - 八进制:
0o或者0O - 十进制:
0d或者0D - 二进制:
0b或者0B
默认进制
如果不加前缀指定进制,数字默认为十进制。
还可以在数字前添加 Nw 或 Ns 指定位宽与符号性,其中 N 是十进制宽度,字面量内部不能有空白或注释:
Nw表示宽度为N的无符号位串,对应类型bit<N>Ns表示宽度为N的有符号整数(二进制补码),对应类型int<N>
w 和 s 是宽度与数字部分之间的分隔符,分别选择无符号和有符号类型。
例子:
32w255          // 32位无符号数,值为255
32w0d255        // 同上
32w0xFF         // 同上
32s0xFF         // 32位有符号数,值为255
8w0b10101010    // 8位无符号数,值为170
8w0b_1010_1010  // 同上
8w170           // 同上
8s0b1010_1010   // 8位有符号数,值为-86
16w0377         // 16位无符号数,值为377(不是255!)
16w0o377        // 16位无符号数,值为255
分隔符
可以在数字间添加下划线 _,让长数字更易读。例如上面的 8w0b_1010_1010。
注意
很多语言把前缀 0 视为八进制,相当于 0o,P4 则会当成十进制处理。例如上面的 0377,在 C 语言看来就是八进制的 0o377,相当于十进制的 255,而 P4 就会当成十进制的 377。
字符串
字符串由双引号包围。双引号前连续出现奇数个反斜杠时,该双引号不结束字符串,因此可以写入 \"。P4 不规定完整的转义序列解释规则,也不检查字符串是否为合法 UTF-8,具体处理由使用字符串的工具决定。
例子:
"simple string"
"string \" with \" embedded \" quotes"
"string with embedded
line terminator"
尾随逗号
P4 允许部分逗号分隔的列表以逗号结尾,例如枚举成员和结构化注解的主体。不能据此给所有列表添加尾随逗号。表的 actions 列表使用分号分隔。
例如,下面两种写法是一样的:
enum E {
    a, b, c
}

enum E {
    a, b, c,
}
与预处理器指令结合相当有用:
enum E {
#if SUPPORT_A
    a,
#endif
    b,
    c,
}
参数修饰
in:调用时复制输入值,参数在被调用者中只读。out:调用结束时把参数值复制回实参,实参必须是可写的左值。调用时不会复制实参原来的值。inout:调用时复制输入值,调用结束时再复制回实参,实参必须是可写的左值。
这套规则称为复制入、复制出(copy-in/copy-out)。实参按调用中出现的顺序从左到右求值,输出值也按这一顺序复制回去,不能直接当作 C++ 引用传递来理解。
out 报头和报头联合体会先被置为无效,out 报头栈的元素也会置为无效且 nextIndex 清零。复合类型递归应用这些规则,普通数值字段则没有确定的初值。
除动作外,无方向参数通常要求实参是编译时已知值。无方向的 extern 对象参数按引用传递,packet_in 和 packet_out 就属于这一类。动作的无方向参数表示动作数据,显式调用时按 in 参数处理,通过表调用时由表项提供。
仅允许为 in 或无方向参数提供默认值,默认表达式必须在编译时已知。省略位于参数列表中间的默认参数时,要使用命名实参。
extern void f(in bit a, in bit<3> b = 2, in bit<5> c);

void g() {
    f(a = 1, b = 2, c = 3);  // 合法
    f(a = 1, c = 3);         // 合法,等价于上一个调用,b 使用默认值
    f(1, 2, 3);              // 合法,等价于上一个调用
    f(1, 3);                 // 非法
}
可选参数
带有 @optional 的参数可以省略,且不能同时设置默认值。它适用于包、解析器类型、控制块类型、外部函数、外部方法和外部对象构造函数,省略后的含义由架构规定。若同一个声明同时包含可选参数和带默认值的参数,使用命名实参调用。例如:
package Pipeline(/* 参数 */);
package Switch(Pipeline first, @optional Pipeline second);

Pipeline(/* 参数 */) ingress;
Switch(ingress) main;  // 一个只有单级流水线的交换机
名称解析
P4 有一个顶层的无名命名空间,里面有全部的顶层声明。通过在标识符前加 .,该标识符将在顶层的命名空间解析。例如:
const bit<32> x = 2;
control c() {
    int<32> x = 0;
    apply {
        x = x + (int<32>).x;  // x 是 int<32> 的局部变量,
                              // .x 是顶层的 bit<32> 变量
    }
}
对标识符的解析是从内到外的,首先查找当前作用域,然后逐层向上查找。例如:
const bit<4> x = 1;
control p() {
    const bit<8> x = 8;   // 局部变量 x 的声明覆盖了全局 x
    const bit<4> y = .x;  // 当前使用的是顶层 x
    const bit<8> z = x;   // 当前为 p 的局部变量 x
    apply {}
}
基本数据类型
P4 的内置基本类型:void error string match_kind bool int bit<> int<> varbit<>
void 类型
空类型,类似 C 语言中的 void 类型。
error 类型
错误类型,所有 error 类型的常量,不论在哪定义的,都会被放进 error 命名空间内。error 类型类似于其他语言中的枚举 enum 类型。一个 P4 程序可以包含多个错误声明,编译器将这些声明合并在一起。
错误成员名称不能重复声明。PacketTooShort 等标准错误已经在 core.p4 中定义,程序只需补充自己的错误:
error { InvalidPacket, UnsupportedProtocol }match_kind 类型
match_kind 类型与 error 类型比较相似,用于声明表的键所支持的匹配方式(如精确匹配、三元匹配、最长前缀匹配等),而不是键本身。该类型声明的标识符都会放到顶层命名空间中。
P4 核心库(core.p4)声明了三种最基础的匹配方式:
match_kind {
    exact,
    ternary,
    lpm
}
具体架构可以追加自己支持的匹配方式,例如 range、selector、optional。不能假定每种架构都支持这些扩展,使用前应检查其声明和目标支持范围。
match_kind 的声明
新的 match_kind 值只能由架构 / 模型描述文件声明,普通 P4 程序里不允许新增。
bool 类型
只有两个值,true 和 false 。
string 类型
字符串类型。P4 不支持对字符串进行操作,无法声明字符串类型的变量。字符串作为函数参数时,也只能是无方向的。
字符串常量
在 P4 程序中,唯一可以出现的字符串是字符串字面量常量。
整数类型
P4 区分任意精度常量与固定宽度整数。大多数算术和比较运算要求固定宽度操作数的位宽、符号性相同,不会像 C 那样自动提升。移位和拼接有各自的规则,目标架构也可以限制可用的位宽和运算。
C 语言比较有符号数和无符号数
混合比较时,C 按通常算术转换规则处理类型,某些组合会把负数转为很大的无符号数。例如:
int a = -1;
unsigned int b = 1;

if (a < b) {
    // 代码块
}在这个例子中,a 转换为 unsigned int。若 unsigned int 为 32 位,实际比较的是 4294967295 < 1,结果为假。数学上的 -1 < 1 为真,两者不同。
无符号整数
无符号整数也叫位串(bit-string),声明语法为 bit<W>。W 必须是局部编译时已知的非负整数。宽度为 0 时没有实际的位,唯一的值为 0。若宽度写成表达式,需要用括号括起来。例如:
const bit<32> x = 10;       // 32位常量,值为10。
const bit<(x + 2)> y = 15;  // 12位常量,值为15。
                            // 宽度的表达式必须使用括号。
位串中的位从 0 到 W−1 编号。位 0 是最低有效位,而位 W−1 是最高有效位。
例如,类型 bit<128> 表示宽度为 128 位的位串值,其中位编号从 0 到 127,位 127 是最高有效位。
提示
bit 是 bit<1> 的简写。
有符号整数
有符号整数采用二进制补码表示。位宽为 W 的有符号整数声明为:int<W>,位 W-1 是符号位。
变长位串
varbit<W> 类型表示宽度最多为 W 位的位串。例如,varbit<120> 类型表示可以有 0 到 120 位的位串值。大多数适用于固定大小位串(bit<W>)的操作不能对动态大小的位串(varbit<W>)执行。
任意精度整数
该类型以 int 表示,用于整数字面量及其编译时常量表达式,不能用于运行时变量。例如:
const int a = 5;
const int b = 2 * a;
const int c = b - a + 3;
动作参数不能使用 int。其他允许无方向参数的可调用实体使用 int 参数时,实参必须在编译时已知。用户定义的普通函数要求所有参数都有方向,因此应使用 bit<W> 或 int<W>,不能用任意精度 int 接收运行时数值。
整数字面量
整数字面量(常量)的类型如下:
- 一个简单的整数字面量的类型为
int。 - 一个以整数宽度
N和字符w为前缀的非负整数的类型为bit<N>。 - 一个以整数宽度
N和字符s为前缀的整数的类型为int<N>。
下表展示了若干整数字面量的示例及其类型。
| 字面量 | 类型 | 实际存储值 | 备注 |
|---|---|---|---|
10 | int | 10 | 任意精度 |
8w10 | bit<8> | 10 | 正好放得下 |
8s10 | int<8> | 10 | 正好放得下 |
2s3 | int<2> | -1 | 3 = 0b11,截到低 2 位 11,2 位补码即 -1(溢出) |
1w10 | bit<1> | 0 | 10 = 0b1010,截到低 1 位 0,所以存的是 0(溢出) |
1s1 | int<1> | -1 | 1 = 0b1,1 位补码 1 即 -1(溢出) |
派生类型
P4 提供的派生类型有:
enum(枚举)header(报头)header stacks(报头栈)struct(结构体)header_union(报头联合体)tuple(元组)list(列表)extern(外部类型)parser(解析器)control(控制块)package(包)
枚举类型
普通 enum 的成员是符号值,不隐式转换为整数。带 bit<W> 或 int<W> 基础类型的枚举具有明确的位表示,称为可序列化枚举,其成员必须显式赋值且能由基础类型表示。
enum Suits { Clubs, Diamonds, Hearts, Spades }

enum bit<16> EtherType {
    VLAN = 0x8100,
    QINQ = 0x9100,
    MPLS = 0x8847,
    IPV4 = 0x0800,
    IPV6 = 0x86dd
}
报头类型
报头字段必须具有明确的位表示,允许以下类型:
bit<W>(无符号定长位串)int<W>(有符号定长整数)varbit<W>(最大宽度为W的变长位串,双参数extract要求报头恰好有一个这样的字段)bool(编码为 1 位,1=true,0=false)- 可序列化枚举(即声明了基础类型的
enum bit<W>/enum int<W>) - 由
bit<W>、int<W>、bool和可序列化枚举组成的struct,可以递归嵌套,但不能在其中放入varbit
字段名称必须唯一。
报头还包含一个隐藏的"有效性"字段。当"有效性"字段为 true 时,该报头有效。当使用报头类型声明局部变量时,其"有效性"位会自动设置为 false。可以使用报头方法 isValid()、setValid() 和 setInvalid() 来操作此有效性位。
注意
报头不能嵌套其他报头、报头栈或报头联合体(但可以嵌套 struct)。
报头类型可以为空:
header Empty_h { }注意
即使是空报头也仍然包含一个有效性位。
当结构体位于报头内部时,extract 和 emit 按源代码中的字段声明顺序处理。例如:
struct ipv6_addr {
    bit<32> Addr0;
    bit<32> Addr1;
    bit<32> Addr2;
    bit<32> Addr3;
}

header ipv6_t {
    bit<4>    version;
    bit<8>    trafficClass;
    bit<20>   flowLabel;
    bit<16>   payloadLen;
    bit<8>    nextHdr;
    bit<8>    hopLimit;
    ipv6_addr src;
    ipv6_addr dst;
}
不包含 varbit 字段的报头为固定大小报头,包含 varbit 字段的报头为可变大小报头。固定大小报头的位数是所有组成字段位数之和,不包括有效性位,也没有隐式填充或对齐。目标可以进一步要求报头大小为整数字节。
例如,声明一个以太网报头:
header Ethernet_h {
    bit<48> dstAddr;
    bit<48> srcAddr;
    bit<16> etherType;
}
声明一个 Ethernet_h 类型的变量:
Ethernet_h ethernetHeader;P4 提供了一个 extract 方法,可用于从网络数据包中填充报头字段,extract 操作成功执行后,会将被提取报头的有效性位设置为 true。
报头栈
报头栈表示同一报头类型或报头联合体类型的定长数组,长度在编译时已知。例如:
header Mpls_h {
    bit<20> label;
    bit<3> tc;
    bit<1> bos;
    bit<8> ttl;
}
Mpls_h[10] mpls;
引入了一个名为 mpls 的报头栈,包含 10 个 Mpls_h 类型的报头。
报头联合体
报头联合体的每个字段都必须是报头类型。字段列表可以为空,且字段名称必须唯一。
例如,下面的 Ip_h 类型表示 IPv4 和 IPv6 的报头联合体:
header_union IP_h {
    IPv4_h v4;
    IPv6_h v6;
}
结构体
结构体的字段名称必须唯一。空结构体(没有字段)是合法的。例如,下面的 Parsed_headers 结构体包含简单解析器识别的报头:
header Tcp_h { /* 字段省略 */ }
header Udp_h { /* 字段省略 */ }
struct Parsed_headers {
    Ethernet_h ethernet;
    Ip_h       ip;
    Tcp_h      tcp;
    Udp_h      udp;
}
元组
语法:tuple<类型列表>
例如:
tuple<bit<32>, bool> pair;列表
列表包含任意个值,其中每个元素必须具有相同的类型。所有元素都是 T 类型的列表的类型写为:list<T>。
列表值写为 (list<T>){元素列表},可以传给外部对象构造函数等接口。它不等同于能够在数据平面任意增删元素的动态数组,具体用途由接收它的声明决定。
外部类型
extern 用来声明由目标实现的函数或对象接口。P4 程序只看到方法签名,实际行为由架构定义。寄存器、计数器和校验单元常通过它提供,core.p4 中的 packet_in、packet_out 也是外部类型。外部对象需要实例化,不能像普通结构体一样赋值复制。
解析器类型
解析器应该至少有一个类型为 packet_in 的参数,代表正在处理的接收数据包。
例如,以下是一个名为 P 的解析器类型的声明,它以类型变量 H 进行参数化。该解析器接收一个 packet_in 值 b 作为输入,并产生两个值:
- 一个用户定义类型
H的值 - 一个预定义类型
Counters的值
struct Counters { /* 字段省略 */ }
parser P<H>(packet_in b,
            out H packetHeaders,
            out Counters counters);
控制块类型
与解析器类型声明类似。
包类型
包的参数在编译时求值,所以它们必须是无方向的(不能是 in、out 或 inout)。
默认值
一些类型定义了默认值,可通过 ... 显式请求使用。声明普通变量时省略初始化器,不会自动得到这些默认值。报头相关类型的有效位和报头栈索引有单独的初始化规则。
- 对于
int、bit<N>和int<N>类型,默认值为0。 - 对于
bool,默认值为false。 - 对于
error,默认值为error.NoError(在core.p4中定义)。 - 对于
string,默认值为空字符串""。 - 对于
varbit<N>,默认值为当前宽度为 0 的空位串,而非包含N个零的位串。 - 对于有基础类型的枚举,默认值为数值
0,即使枚举没有声明值为0的成员。 - 对于普通枚举,默认值为声明中的第一个成员。
- 对于
header,默认报头有效位为false。 - 对于
header stack,默认值为所有报头有效位为false且nextIndex为0。 - 对于
header_union,默认值为所有报头有效位为false。 - 对于
struct和tuple,各字段递归使用对应类型的默认值,前提是每个字段类型都有默认值。
注意
有些类型没有默认值,例如 match_kind、集合类型、函数类型、外部类型、解析器类型、控制块类型和包类型。
typedef
和 C 类似,例如:
typedef bit<32> u32;
typedef struct Point { int<32> x; int<32> y; } Pt;
typedef Empty_h[32] HeaderStack;
也可以和泛型一起使用,例如:
struct S<T> {
    T field;
}

// typedef S X;       // 非法:S 缺少类型实参
typedef S<bit<32>> X;  // 合法
type
typedef 只是别名,type 则引入独立的新类型。新类型与基础类型不能直接混用,需要显式转换:
type bit<9> PortId_t;

// 以下声明放在控制块等允许局部变量的位置
PortId_t port = (PortId_t)1;
bit<9> raw = (bit<9>)port;P416 v1.2.5 的 type 基础类型限于 bit<W>、int<W>、bool 及从它们派生的新类型,不能用它定义新的结构体类型。
3 类型转换
语法:(t) e,其中 t 是类型,e 是表达式。
3.1 显式类型转换
规范 §8.11.1 允许的主要显式转换有:
bit<1> <-> bool:0与false可以互转,1与true可以互转。int -> bool:仅允许任意精度常量0和1,分别转换为false和true。int<W>不能直接转换为bool。int<W> -> bit<W>:保持所有位不变,将符号位当成数值位处理。bit<W> -> int<W>:保持所有位不变,将最高位当成符号位处理。bit<W> -> bit<X>:如果W > X则截断该值,如果W < X则用0填充。int<W> -> int<X>:如果W > X则截断该值,如果W < X则用符号位填充。bit<W> -> int:保持值不变,转换为无限精度整数。int<W> -> int:保持值不变,转换为无限精度整数。int -> bit<W>:将二进制补码位串截断至W位。int -> int<W>:将二进制补码位串截断至W位。- 可序列化枚举与其基础类型之间可以互转。
- 用
type声明的类型与其基础类型之间可以互转。 - 结构值表达式可以转换为相应结构体或报头类型,元组表达式可以转换为报头栈类型,
{#}可以转换为报头或报头联合体类型。
不能一步完成的转换
bit<W> 与 int<X> 之间宽度不同时不能一步转换,必须先转宽度再转符号性(或反过来),例如 (int<8>)(bit<8>)y。
3.2 隐式类型转换
P4 的隐式数值转换限于从 int 转为固定宽度整数,以及从可序列化枚举转为其基础类型。移位和拼接不会把任意精度常量按另一操作数的宽度转换。例如,x << 256 中的 256 不会截断成 8 位的 0。
例如,对应下面这些声明:
enum bit<8> E {
    a = 5
}

bit<8>  x;
bit<16> y;
int<8>  z;
可以有以下这些隐式转换:
x + 1变x + (bit<8>)1z < 0变z < (int<8>)0x | 0xFFF变x | (bit<8>)0xFFF,常量截断为0xFF,编译器应给出溢出警告x + E.a变x + (bit<8>)E.ax &&& 8变x &&& (bit<8>)816w11 << E.a变16w11 << (bit<8>)E.ax[E.a:0]变x[(bit<8>)E.a:0]E.a ++ 8w0变(bit<8>)E.a ++ 8w0
3.3 非法算术表达式
一些在 C 允许的算术表达式,在 P4 中不允许。例如,有如下声明:
bit<8>  x;
bit<16> y;
int<8>  z;
下表列举了多个非法表达式,并给出了多种合法的替代写法:
| 表达式 | 错误原因 | 替代方案 |
|---|---|---|
x + y | 位宽不同 | (bit<16>)x + yx + (bit<8>)y |
x + z | 符号性不同 | (int<8>)x + zx + (bit<8>)z |
(int<8>)y | 不能同时修改符号性和位宽 | (int<8>)(bit<8>)y(int<8>)(int<16>)y |
y + z | 位宽和符号性均不同 | (int<8>)(bit<8>)y + z(bit<8>)y + (bit<8>)z(int<16>)y + (int<16>)z |
x << z | 位移符右侧不能是有符号数 | x << (bit<8>)z |
x < z | 符号性不同 | x < (bit<8>)z(int<8>)x < z |
1 << x | 对任意精度整数按位操作 | 32w1 << x |
~1 | 对任意精度整数按位操作 | ~32w1 |
5 & -3 | 对任意精度整数按位操作 | 32w5 & -3 |
固定宽度运算不会自动扩宽。若 n 是 bit<8>,8 * n - 16 仍按 8 位计算,结果再转换为 bit<32> 已无法恢复溢出的高位。需要更宽的结果时,应先扩宽操作数,例如 ((bit<32>)n - 2) * 8,并先检查 n >= 2。
4 集合的操作
4.1 单元素集合
例:
select (hdr.ipv4.version) {
    4: continue;
}
标签 4 表示包含整数值 4 的单元素集合。
4.2 全集
例:
select (hdr.ipv4.version) {
    4: continue;
    _: reject;
}
default 或 _ 表示全集,它包含给定类型的所有可能值。
4.3 中缀运算符
&&&
中缀运算符 &&& 接受两个相同数值类型 T 的参数,表示类型为 set<T> 的键集。右侧充当掩码,掩码中为 0 的位可以取任意值,匹配条件为 (候选值 & 掩码) == (给定值 & 掩码)。它常用于 select 和表的初始表项。set<T> 是编译器内部合成的类型,不能据此声明 P4 集合变量。
例如:
8w0x0A &&& 8w0x0F表示一个包含 16 种 bit<8> 值的集合,位模式为 XXXX1010,其中 X 可以是 0 或 1。
..
中缀运算符 .. 接受两个相同数值类型 T 的参数,并创建一个类型为 set<T> 的值。该集合包含两个数值间的所有数值,也包括这两个值。例如:
5s5 .. 5s8上式包含四个连续的 int<5> 值:5、6、7、8。若写成 4s8,4 位补码会把它解释为 -8,因此 4s5 .. 4s8 实际上是空集合。一般情况下,第二个端点小于第一个端点就表示空集合。
4.4 笛卡尔积
多个集合可以通过笛卡尔积进行组合:
select(hdr.ipv4.ihl, hdr.ipv4.protocol) {
    (4w0x5, 8w0x1): parse_icmp;
    (4w0x5, 8w0x6): parse_tcp;
    (4w0x5, 8w0x11): parse_udp;
    (_, _): accept;
}
5 结构体的操作
通过点符号访问结构体字段:s.field。
只有在两个结构体具有相同类型且其所有字段都可以递归地进行比较时,才能进行相等(==)或不相等(!=)的比较。只有当两个结构体的所有对应字段都相等时,它们才被认为是相等的。
下面展示按位置、按字段名初始化,以及显式指定类型的写法:
struct S {
    bit<32> a;
    bit<32> b;
}

const S x1 = { 10, 20 };
const S x2 = { a = 10, b = 20 };
const S x3 = (S) { a = 10, b = 20 };
6 报头的操作
报头拥有与结构体相同的操作。此外,报头有“有效性”位,支持以下方法:
isValid()方法返回报头的“有效性”位的值。setValid()方法将报头的“有效性”位设置为true。setInvalid()方法将报头的“有效性”位设置为false。
报头的初始化方式与结构体类似,例如:
header H { bit<32> x; bit<32> y; }
H h;
h = { 10, 12 };
h = { y = 12, x = 10 };
只有同类型报头才能进行 == 或 != 比较。两个报头都无效时相等,不比较字段。两个报头都有效时,只有所有对应字段相等才相等。一个有效、一个无效时不相等。
报头之间的赋值会复制字段和有效位。用字段列表初始化报头会使它有效,但单独调用 setValid() 不会初始化字段。读取无效报头字段,或读取有效报头中尚未初始化的字段,都会得到未指定的值。写入无效报头的字段也不会使其自动有效,应先设置有效位,再写入需要使用的字段。
{#} 表示无效报头,具体类型由上下文决定。若编译器无法推断类型,需写显式转换,例如 (H){#}:
header H { bit<32> x; bit<32> y; }
H h;
h = (H){#};  // 这会使报头 h 变为无效
if (h == (H){#}) {  // 这相当于条件 !h.isValid()
    // ...
}
注意
这里的 # 字符不要误解为预处理指令。
7 报头栈的操作
报头栈的元素可以是同类型的报头,也可以是同类型的报头联合体。栈中的有效元素不需要连续。下方伪代码表示类型为 h[n] 的报头栈 hs:
// 类型声明
struct hs_t {
    bit<32> nextIndex;
    bit<32> size;
    h[n] data; // 普通数组
}

// 实例声明和初始化
hs_t hs;
hs.nextIndex = 0;
hs.size = n;
报头栈可以看作是一个包含报头数组 hs 和计数器 nextIndex 的结构体。nextIndex 用于简化构建报头栈解析器的过程,初始化为 0。
给定一个大小为 n 的报头栈 hs,下面的表达式都是合法的:
hs[index]:返回指定位置的元素引用。编译时已知的索引越界必须报编译错误,运行时索引越界产生未定义值,不能当作.next越界时的解析器错误处理。目标可以不支持运行时索引。hs.size:返回类型为bit<32>的栈长度,值在局部编译时已知。- 把一个报头栈赋值给另一个报头栈,要求类型完全相同。
hs的所有元素都会被复制,包括各个报头的有效位,以及nextIndex。
P4 提供了一些自动推进栈元素解析的运算:
hs.next:返回栈中索引为hs.nextIndex的元素引用。仅能在解析器中使用。如果栈的nextIndex >= size,则报错error.StackOutOfBounds。hs.last:返回索引为hs.nextIndex - 1的元素引用,只能读取,不能作为左值。仅能在解析器中使用。如果nextIndex < 1 || nextIndex > size,则转入reject并设置error.StackOutOfBounds。hs.lastIndex:返回类型为bit<32>的索引hs.nextIndex - 1。仅能在解析器中使用,nextIndex == 0时结果未定义。
P4 还给了一些操作报头栈前后元素的方法:
hs.push_front(int count):向较大索引方向移动count个元素,前面的空位变为无效,超出栈长度的元素丢弃。nextIndex增加count,但不超过栈长度。hs.pop_front(int count):向较小索引方向移动count个元素,尾部空位变为无效。nextIndex减少count,但不小于0。
两种方法都返回 void,count 必须是编译时已知的正整数。这里移动的单位是栈元素,不是报头中的比特。
下面伪代码定义了 push_front 和 pop_front 的行为:
void push_front(int count) {
    for (int i = this.size-1; i >= 0; i -= 1) {
        if (i >= count) {
            this[i] = this[i-count];
        } else {
            this[i].setInvalid();
        }
    }
    this.nextIndex = this.nextIndex + count;
    if (this.nextIndex > this.size) this.nextIndex = this.size;
    // 注意:this.last, this.next 和 this.lastIndex 会随着 this.nextIndex 调整
}

void pop_front(int count) {
    for (int i = 0; i < this.size; i++) {
        if (i+count < this.size) {
            this[i] = this[i+count];
        } else {
            this[i].setInvalid();
        }
    }
    if (this.nextIndex >= count) {
        this.nextIndex = this.nextIndex - count;
    } else {
        this.nextIndex = 0;
    }
    // 注意:this.last, this.next 和 this.lastIndex 会随着 this.nextIndex 调整
}
与结构体和报头类似,两个报头栈可以进行相等 (==) 或不等 (!=) 比较,前提是它们具有相同的元素类型和长度。两个栈相等的条件是它们所有对应的元素都相等,nextIndex 的值不参与比较。
报头栈初始化示例:
header H {
    bit<32> b;
    bit<32> t;
}
H[3] s = (H[3]){ {0, 1}, {2, 3}, (H){#} };
// 不使用显式转换
H[3] s1 = { {0, 1}, {2, 3}, (H){#} };
// 使用默认初始化
H[3] s2 = { {0, 1}, {2, 3}, ... };
8 报头联合体的操作
声明报头联合体变量时,所有成员报头初始无效。它不能像结构体那样用普通字段列表初始化,但可以赋值为无效表达式 {#},也可以复制同类型联合体。联合体的有效性由成员报头决定,同一时刻至多一个成员有效。
现在有如下报头和报头联合体:
header H1 {
    bit<8> f;
}
header H2 {
    bit<16> g;
}
header_union U {
    H1 h1;
    H2 h2;
}

U u;  // u 无效
可以通过给内部元素赋值使得报头联合体生效:
U u;
H1 my_h1 = { 8w0 };  // my_h1 有效
u.h1 = my_h1; // u 和 u.h1 都有效U u;
u.h2 = { 16w1 }; // u 和 u.h2 都有效或者直接修改它们的有效位:
U u;
u.h1.setValid();  // u 和 u.h1 都有效
H1 my_h1 = u.h1;  // my_h1 现在有效,但包含一个未定义的值
注意
有效位为 true 不代表字段已经初始化。读取未初始化字段得到未指定的值,不能假定为零或保留之前的值。
读取报头联合体 u 中的一个报头 hi:u.hi。
对指定报头的有效位操作:
u.hi.setValid():将报头hi的有效位设置为true,同时把同一联合体里其他报头的有效位都置为false(联合体语义保证同一时刻至多一个成员有效)。u.hi.setInvalid():将指定成员hi置为无效。若它原本是有效成员,联合体随之无效。
v1.2.5 §8.19 对 setInvalid() 使用了“任意成员”的措辞,存在歧义。p4c 的联合体处理代码对指定成员执行失效操作,因此这里按参考实现说明。若另一成员有效,不能认为它在调用前已经无效,也不应依赖对无效成员调用此方法来清空整个联合体。
给报头联合体字段赋值的语句 u.hi = e,含义如下:
- 如果
e有效位为true,赋值语句等价于:
u.hi.setValid();
u.hi = e;- 如果
e有效位为false,赋值语句等价于:
u.hi.setInvalid();u.isValid() 在存在有效成员时返回 true,所有成员无效时返回 false。它不是对所有成员有效位求逻辑与。
报头联合体本身没有 setValid() 和 setInvalid() 方法,想置位只能通过具体成员 u.hi.setValid() / u.hi.setInvalid()。
下面的例子展示了如何使用 header_union 来统一表示 IPv4 和 IPv6 报头:
header_union IP {
    IPv4 ipv4;
    IPv6 ipv6;
}

struct Parsed_packet {
    Ethernet ethernet;
    IP ip;
}

parser top(packet_in b, out Parsed_packet p) {
    state start {
        b.extract(p.ethernet);
        transition select(p.ethernet.etherType) {
            16w0x0800 : parse_ipv4;
            16w0x86DD : parse_ipv6;
        }
    }

    state parse_ipv4 {
        b.extract(p.ip.ipv4);
        transition accept;
    }

    state parse_ipv6 {
        b.extract(p.ip.ipv6);
        transition accept;
    }
}
另一个例子使用 header union 来解析(选定的)TCP 选项:
#include <core.p4>

error { InvalidTcpOption }

header Tcp_option_end_h {
    bit<8> kind;
}
header Tcp_option_nop_h {
    bit<8> kind;
}
header Tcp_option_ss_h {
    bit<8>  kind;
    bit<8>  length;
    bit<16> maxSegmentSize;
}
header Tcp_option_s_h {
    bit<8>  kind;
    bit<8>  length;
    bit<8>  scale;
}
header Tcp_option_sack_h {
    bit<8>      kind;
    bit<8>      length;
    varbit<256> sack;
}
header_union Tcp_option_h {
    Tcp_option_end_h  end;
    Tcp_option_nop_h  nop;
    Tcp_option_ss_h   ss;
    Tcp_option_s_h    s;
    Tcp_option_sack_h sack;
}

typedef Tcp_option_h[10] Tcp_option_stack;

struct Tcp_option_sack_top {
    bit<8> kind;
    bit<8> length;
}

// 调用时,b 的当前位置应是 TCP 选项区的起点。
parser Tcp_option_parser(packet_in b, out Tcp_option_stack vec,
                         in bit<32> optionsSizeInBytes) {
    bit<32> remaining;

    state start {
        verify(optionsSizeInBytes <= 40 && optionsSizeInBytes % 4 == 0,
               error.InvalidTcpOption);
        remaining = optionsSizeInBytes;
        transition dispatch;
    }
    state dispatch {
        transition select(remaining) {
            0: accept;
            default: parse_kind;
        }
    }
    state parse_kind {
        transition select(b.lookahead<bit<8>>()) {
            8w0x0 : parse_tcp_option_end;
            8w0x1 : parse_tcp_option_nop;
            8w0x2 : parse_tcp_option_ss;
            8w0x3 : parse_tcp_option_s;
            8w0x5 : parse_tcp_option_sack;
        }
    }
    state parse_tcp_option_end {
        b.extract(vec.next.end);
        // 跳过结束标记后的选项区填充,不读取 TCP 载荷。
        b.advance((remaining - 1) * 8);
        transition accept;
    }
    state parse_tcp_option_nop {
        b.extract(vec.next.nop);
        remaining = remaining - 1;
        transition dispatch;
    }
    state parse_tcp_option_ss {
        verify(remaining >= 4, error.InvalidTcpOption);
        verify(b.lookahead<Tcp_option_sack_top>().length == 4,
               error.InvalidTcpOption);
        b.extract(vec.next.ss);
        remaining = remaining - 4;
        transition dispatch;
    }
    state parse_tcp_option_s {
        verify(remaining >= 3, error.InvalidTcpOption);
        verify(b.lookahead<Tcp_option_sack_top>().length == 3,
               error.InvalidTcpOption);
        b.extract(vec.next.s);
        remaining = remaining - 3;
        transition dispatch;
    }
    state parse_tcp_option_sack {
        verify(remaining >= 2, error.InvalidTcpOption);
        bit<8> n = b.lookahead<Tcp_option_sack_top>().length;
        verify(n >= 10 && n <= 34 && (n - 2) % 8 == 0,
               error.InvalidTcpOption);
        verify((bit<32>)n <= remaining, error.InvalidTcpOption);
        // 先扩宽 n,再计算 varbit 字段的位数,避免 8 位运算溢出。
        b.extract(vec.next.sack, ((bit<32>)n - 2) * 8);
        remaining = remaining - (bit<32>)n;
        transition dispatch;
    }
}
这个例子在规范示例的基础上修正了选项格式和长度计算。MSS 选项含 1 字节长度字段和 2 字节 MSS 值,参见 RFC 9293。Window Scale 选项总长为 3 字节,参见 RFC 7323。SACK 选项长度为 2 + 8 * 块数,参见 RFC 2018。
调用者应先校验 TCP Data Offset,再传入选项区的字节数。这里只演示所列选项,其他种类会拒绝解析。栈容量为 10,超过容量也会拒绝。结束标记后的填充被跳过,若需要重新发出完整 TCP 报头,还需保留填充或重新构造对齐。
与报头 header 类似,{#} 可以表示无效的报头联合体。例如:
header_union HU { ... }
HU h = (HU){#};  // 无效的报头联合体。等同于未初始化的报头联合。
同类型联合体可以比较是否相等。两者全都无效时相等,或者两者具有同一个有效成员且该成员报头相等。
9 函数调用
在函数调用的时候,可以为每个参数都指定参数名。但是不能只指定一部分参数名,要么所有参数都指定参数名,要么都不指定。
例如:
extern void f(in bit<32> x, out bit<16> y);
bit<32> xa = 0;
bit<16> ya;
f(xa, ya);          // 按照位置匹配参数
f(x = xa, y = ya);  // 按照名称匹配参数
f(y = ya, x = xa);  // 按照名称匹配参数,顺序任意
f(x = xa);          // 错误:参数不够
f(x = xa, x = ya);  // 错误:参数重复指定
f(x = xa, ya);      // 错误:只有部分参数指定了名称
f(z = xa, w = ya);  // 错误:没有名为 z 或 w 的参数
f(x = xa, y = 0);   // 错误:y 必须是一个左值
提示
上面例子中的最后一行,因为 y 的参数方向是 out,所以传进来的实参必须是一个可修改的左值(lvalue)。
10 构造函数的调用
以下结构拥有构造函数:
externparsercontrolpackage
这些对象在编译时分配,构造函数实参必须是编译时已知值。下面的 implementation 是目标相关的表属性,具体是否支持 ActionProfile 要看架构声明。
例如:
extern ActionProfile {
    ActionProfile(bit<32> size); // 构造函数
}
table tbl {
    actions = { /* 省略内容 */ }
    implementation = ActionProfile(1024);  // 构造函数调用
}
11 使用默认值初始化
通过默认值初始化的语法为 ...。例如:
struct S {
    bit<32> b32;
    bool    b;
}

enum int<8> N0 {
    one  = 1,
    zero = 0,
    two  = 2
}

enum N1 {
    A, B, C, F
}

struct T {
    S  s;
    N0 n0;
    N1 n1;
}

header H {
    bit<16> f1;
    bit<8>  f2;
}

N0 n0 = ...;                // 使用默认值 0 初始化 n0
N1 n1 = ...;                // 使用默认值 N1.A 初始化 n1
S  s0 = ...;                // 使用默认值 { 0, false } 初始化 s0
S  s1 = { 1, ... };         // 使用值 { 1, false } 初始化 s1
S  s2 = { b = true, ... };  // 使用值 { 0, true } 初始化 s2
T  t0 = ...;                // 使用值 { { 0, false }, 0, N1.A } 初始化 t0
T  t1 = { s = ..., ... };   // 使用值 { { 0, false }, 0, N1.A } 初始化 t1
T  t2 = { s = ... };        // 错误:未为字段 n0 和 n1 指定初始化器
tuple<N0, N1> p = { ... };  // 使用默认值 { 0, N1.A } 初始化 p
T  t3 = { ..., n0 = 2};     // 错误:... 必须位于最后
H  h1 = ...;                // 初始化 h1 为无效的头
H  h2 = { f2=5, ... };      // 初始化 h2 为有效的头,字段 f1 为 0,字段 f2 为 5
H  h3 = { ... };            // 初始化 h3 为有效的头,字段 f1 为0,字段 f2 为0
12 函数声明
函数只能在最外层声明,并且所有参数都必须有方向。例如:
bit<32> max(in bit<32> left, in bit<32> right) {
    return (left > right) ? left : right;
}
提示
P4 不支持递归函数。非 void 函数的所有执行路径都必须返回类型匹配的值。外部函数的声明和调用另有规则,其实现由目标提供。
13 常量声明
例如:
const bit<32> COUNTER = 32w0x0;
struct Version {
    bit<32> major;
    bit<32> minor;
}
const Version version = { 32w0, 32w0 };
常量的初始化表达式必须在编译时已知。普通局部变量可以在解析器、控制块、动作或函数中声明,未显式初始化的数值变量没有确定的初值。局部变量也不会跨数据包保存状态,需要这种能力时,应使用架构提供的寄存器、计数器等 extern 对象。
14 语句
赋值、方法调用、return、exit 等简单语句以分号结尾。块语句、if 和 switch 不应一概追加分号。不同位置对语句种类有限制,例如解析器不支持 return,switch 只能在控制块中使用。解析器状态还支持 transition 语句。
14.1 赋值语句
赋值语句使用 = 编写。extern 类型不支持赋值操作。
14.2 空语句
空语句写作 ;,是一个无操作的语句。
14.3 块语句
块语句由大括号 {} 表示,包含一系列的语句,这些语句按顺序执行。块语句中的变量和常量只在块内可见。
14.4 Return 语句
return 语句立即终止包含它的 action、函数或 control 的执行。不允许出现在解析器 parser 中(parser 用 transition 转入终态)。
具体使用形式:
- 在
action、control、无返回值的函数中:写return;(不带表达式)即可。 - 在有返回值的函数中:必须写成
return expr;,且expr的类型要与函数返回类型匹配。
out 或 inout 参数的 copy-out 行为会在 return 语句执行后完成。
14.5 Exit 语句
exit 语句立即终止当前执行的所有块:当前动作 action(如果在动作 action 中调用)、当前控制块 control 及其所有调用者。exit 语句不允许出现在解析器 parser 或函数中。
任何方向为 out 或 inout 参数的复制行为都会在 exit 语句执行后完成。
14.6 条件语句
语法与大多数编程语言一样。
但是,P4 中的条件表达式必须是 bool 类型,而不能是整数类型。
当多个 if 语句嵌套时,else 会应用于最内层没有 else 语句的 if 语句。
14.7 Switch 语句
switch 语句只能在控制块 control 内使用。
switch 表达式有两种类型,在下面两个小节中描述。
14.7.1 使用 action_run 表达式的 Switch 语句
对于此类 switch 语句,表达式必须是 t.apply().action_run 的形式,其中 t 是一个表的名称。所有 switch 标签必须是表 t 的动作名称,或 default。例如:
switch (t.apply().action_run) {
    action1:  // fall-through 到 action2
    action2: { /* 省略的主体 */ }
    action3: { /* 省略的主体 */ } // action2 到 action3 标签无 fall-through
    default: { /* 省略的主体 */ }
}
14.7.2 使用整数或枚举类型表达式的 Switch 语句
对于此类 switch 语句,表达式必须是下面几种类型之一:
bit<W>int<W>enumerror
这里的普通数值或枚举分支标签必须是编译时已知值,且能按隐式转换规则匹配表达式类型。
示例:
// 假设表达式 hdr.ethernet.etherType 的类型为 bit<16>
switch (hdr.ethernet.etherType) {
    0x86dd: { /* 省略的主体 */ }
    0x0800:  // fall-through 到下一个主体
    0x0802: { /* 省略的主体 */ }
    0xcafe: { /* 省略的主体 */ }
    default: { /* 省略的主体 */ }
}
14.7.3 所有 switch 语句的通用说明
如果 switch 语句中的两个标签相等,则会产生编译时错误。switch 标签值不需要涵盖 switch 表达式的所有可能值。default 标签是可选的,如果使用 default,它必须是 switch 语句中的最后一个。
如果 switch 标签后没有跟随块语句,则会继续执行下一个标签。但如果存在块语句,则不会继续执行下一个标签。若最后一个 switch 标签后未跟随块语句,其行为等同于跟随了一个空块语句 {}。
注意
注意,这与 C 风格的 switch 语句不同,C 中需要使用 break 来防止继续执行。
如果没有标签与 switch 表达式相等,则:
- 如果存在
default标签,则执行带有default标签的块语句。 - 如果不存在
default标签,则不执行任何操作,继续执行switch语句后的代码。
15 数据包解析
15.1 解析器状态
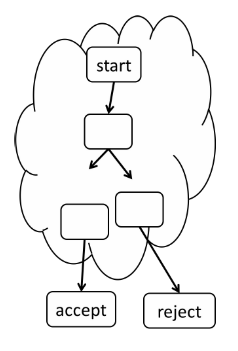
P4 解析器具有一个起始状态和两个最终状态。起始状态名为 start,两个最终状态分别命名为 accept(表示解析成功)和 reject(表示解析失败)。start 状态是解析器的一部分,而 accept 和 reject 状态在逻辑上位于解析器之外。下图展示了解析器的一般结构:
15.2 解析器声明
解析器声明包含一个名称、参数列表、可选的构造函数参数列表、局部元素以及解析器状态。
与解析器类型声明不同,解析器声明不能是泛型的。例如,以下声明是非法的:
parser P<H>(inout H data) { /* 省略主体 */ }这里区分带分号的类型接口声明与带主体的实现声明。v1.2.5 §13.2 和 §14 禁止泛型实现,虽然 §15.1 又给出了泛型直接调用示例,文字并不一致。本文的可执行示例遵循前两节的限制,不依赖这一矛盾示例。
在任何解析器中,至少必须存在一个状态,名为 start。解析器不能定义两个具有相同名称的状态。解析器也不能显式定义 accept 和 reject 状态。
在解析器状态之前,解析器还可以包含一个局部元素列表。这些局部元素可以是常量、变量,或者解析器中可能使用的对象实例化。
局部声明还可以包含 value_set。可以实例化 extern 或子解析器,但不能在解析器中实例化控制块。解析器到达 reject 后是否丢包,由架构及后续处理决定,语言本身不把拒绝解析等同于丢包。
状态和局部元素共享相同的命名空间,因此,以下示例会产生错误:
// 错误示例
parser p() {
    bit<4> t;
    state start {
        t = 1;
        transition t;
    }
    state t {  // 错误:名称 t 重复
        transition accept;
    }
}
15.3 转换语句
解析器状态中的最后一条语句是一个可选的转换语句,用于将控制权转移到另一个状态,可能是 accept 或 reject。
例如,以下语句:
transition accept;终止当前解析器的执行,并立即转移到 accept 状态。
如果状态块的主体不以转换语句结束,则隐含的语句为:
transition reject;15.4 select 表达式
select 表达式会计算出一个状态。
键集从上到下匹配,采用第一个匹配分支,允许分支重叠。如果没有分支匹配,解析器进入 reject 并设置 error.NoMatch。default 或 _ 匹配所有值,放在它们之后的分支无法到达。
select 表达式的典型用法是将最近提取的头字段的值与一组常量值进行比较,例如:
header IPv4_h { bit<8> protocol; /* 省略更多字段 */ }
struct P { IPv4_h ipv4; /* 省略更多字段 */ }
P headers;
select (headers.ipv4.protocol) {
    8w6  : parse_tcp;
    8w17 : parse_udp;
    _    : accept;
}
例如,要检测 TCP 保留端口(小于 1024),可以这样写:
select (p.tcp.port) {
  16w0 &&& 16w0xFC00: well_known_port;
  _: other_port;
}
表达式 16w0 &&& 16w0xFC00 描述了最高有效的六位为零的 16 位值。
15.5 verify 语句
verify 语句提供了一种简单的错误处理方式。verify 只能在解析器中调用,语法上类似于一个具有以下签名的函数:
extern void verify(in bool condition, in error err);如果第一个参数为真,执行该语句不会产生任何影响。如果第一个参数为假,则会立即跳转到 reject 状态,导致解析过程立即终止。同时,与解析器关联的 parserError 将被设置为第二个参数 err 的值。
在 ParserModel 中,verify 语句的语义可以表示为:
ParserModel.verify(bool condition, error err) {
    if (condition == false) {
        ParserModel.parserError = err;
        goto reject;
    }
}
15.6 数据提取
P4 核心库中的 packet_in 是表示输入报文的内建 extern 类型。用户不能显式实例化它,由架构为顶层解析器提供。子解析器接收的是传入的同一外部对象,读取位置也随它的提取操作推进。
extern packet_in {
    void extract<T>(out T hdr);
    void extract<T>(out T variableSizeHeader,
                    in bit<32> variableFieldSizeInBits);
    T lookahead<T>();
    void advance(in bit<32> sizeInBits);
    bit<32> length();  // 返回整个输入包的字节数,部分目标可能不支持
}
要从类型为 packet_in 的参数 b 表示的数据包中提取数据,解析器调用 b 的 extract 方法。extract 方法有两个变体:一个参数的变体用于提取固定大小的报头,两个参数的变体用于提取可变大小的报头。由于这些操作可能导致运行时验证失败,这些方法只能在解析器中执行。
将数据提取到位串或整数时,第一个数据包位被提取到整数的最高有效位。
某些目标可能在所有字节接收完之前(即在数据包的长度已知之前)开始处理数据包,此时,packet_in.length() 无法使用。
在 ParserModel 中,packet_in 的语义可以使用以下数据包的抽象模型来描述:
packet_in {
    unsigned nextBitIndex;
    byte[] data;
    unsigned lengthInBits;
    void initialize(byte[] data) {
        this.data = data;
        this.nextBitIndex = 0;
        this.lengthInBits = data.sizeInBytes * 8;
    }
    bit<32> length() { return this.lengthInBits / 8; }
}
15.6.1 固定宽度提取
单参数 extract 方法处理固定宽度的报头,在 P4 中声明如下:
void extract<T>(out T headerLeftValue);例如,以下程序片段提取一个以太网头:
struct Result { Ethernet_h ethernet; /* 省略其他字段 */ }
parser P(packet_in b, out Result r) {
    state start {
        b.extract(r.ethernet);
        transition accept;
    }
}
15.6.2 可变宽度提取
双参数的 extract 方法处理可变宽度的报头,在 P4 中声明如下:
void extract<T>(out T headerLvalue, in bit<32> variableFieldSize);第二个参数表示唯一 varbit 字段的位数,不是整个报头的位数。报文剩余数据不足时设置 error.PacketTooShort,请求宽度超过报头声明的上限时设置 error.HeaderTooShort。目标还可以要求提取长度按字节对齐。
以下示例展示了一种解析 IPv4 options 的方法,通过将 IPv4 报头分成两个单独的报头:
// 不带选项的IPv4报头
header IPv4_no_options_h {
    bit<4>  version;
    bit<4>  ihl;
    bit<8>  diffserv;
    bit<16> totalLen;
    bit<16> identification;
    bit<3>  flags;
    bit<13> fragOffset;
    bit<8>  ttl;
    bit<8>  protocol;
    bit<16> hdrChecksum;
    bit<32> srcAddr;
    bit<32> dstAddr;
}
header IPv4_options_h {
    varbit<320> options;
}

struct Parsed_headers {
    // 省略了一些字段
    IPv4_no_options_h ipv4;
    IPv4_options_h    ipv4options;
}

error { InvalidIPv4Header }

parser Top(packet_in b, out Parsed_headers headers) {
    // 省略了一些 state

    state parse_ipv4 {
        b.extract(headers.ipv4);
        verify(headers.ipv4.ihl >= 5, error.InvalidIPv4Header);
        transition select (headers.ipv4.ihl) {
            5: dispatch_on_protocol;
            _: parse_ipv4_options;
        }
    }

    state parse_ipv4_options {
        // 使用 IPv4 报头中的信息计算要提取的位数
        b.extract(headers.ipv4options, (bit<32>)(((bit<16>)headers.ipv4.ihl - 5) * 32));
        transition dispatch_on_protocol;
    }
}
ihl 字段
在 IPv4 报头中,ihl 是 "Internet Header Length"(互联网报头长度)的缩写。ihl 字段占4位,表示 IPv4 报头的长度,单位是 32 位字(即 4 字节)。该字段的最小值是 5,这表示没有 options 字段的 IPv4 报头长度为 20 字节。如果 ihl 的值大于 5,说明报头中包含了 options 字段。
若 ihl 小于 5,上面的 verify 会拒绝解析并设置 error.InvalidIPv4Header,已提取报头的有效位不会因此自动清零。
15.6.3 预提取
lookahead 方法由 packet_in 提供,预读当前位置上的 T 类型值,但不改变 nextBitIndex,下一次 extract 仍从同一位置开始。数据包剩余比特不足时,它进入 reject 并设置 error.PacketTooShort。若返回值包含报头,成功预读的这些报头均有效。
lookahead 方法可以如下调用:
b.lookahead<T>()其中,T 必须是固定宽度的类型。如果执行成功,lookahead 返回的结果是类型 T 的一个值。
在抽象模型 ParserModel 中,lookahead 的语义可以用以下伪代码表示:
T packet_in.lookahead<T>() {
    bitsToExtract = sizeof(T);
    lastBitNeeded = this.nextBitIndex + bitsToExtract;
    ParserModel.verify(this.lengthInBits >= lastBitNeeded, error.PacketTooShort);
    T tmp = this.data.extractBits(this.nextBitIndex, bitsToExtract);
    return tmp;
}
第 8 章中的 TCP 选项提取的例子也展示了 lookahead 的使用方式:
state parse_kind {
    transition select(b.lookahead<bit<8>>()) {
        0: parse_tcp_option_end;
        1: parse_tcp_option_nop;
        2: parse_tcp_option_ss;
        3: parse_tcp_option_s;
        5: parse_tcp_option_sack;
    }
}

// 省略了一些状态

state parse_tcp_option_sack {
    verify(remaining >= 2, error.InvalidTcpOption);
    bit<8> n = b.lookahead<Tcp_option_sack_top>().length;
    verify(n >= 10 && n <= 34 && (n - 2) % 8 == 0,
           error.InvalidTcpOption);
    verify((bit<32>)n <= remaining, error.InvalidTcpOption);
    b.extract(vec.next.sack, ((bit<32>)n - 2) * 8);
    remaining = remaining - (bit<32>)n;
    transition dispatch;
}
15.6.4 跳位
P4 提供了两种跳过数据包的位而不将其分配给报头的方法:
一种方法是将位提取到下划线标识符 _,并明确指定数据的类型:
b.extract<T>(_);T 必须是符合单参数 extract 要求的固定大小报头类型,不能把它当作提取任意类型的接口。
另一种方法是在已知跳过的位数时,使用数据包的 advance 方法。
在抽象模型 ParserModel 中,advance 的含义用伪代码表示如下:
void packet_in.advance(bit<32> bits) {
    // 目标允许包含以下行,但不需要
    // verify(bits[2:0] == 0, error.ParserInvalidArgument);
    lastBitNeeded = this.nextBitIndex + bits;
    ParserModel.verify(this.lengthInBits >= lastBitNeeded, error.PacketTooShort);
    this.nextBitIndex += bits;
}
15.7 报头栈
报头栈具有两个属性 next 和 last,可用于解析。例如,下面的声明定义了一个栈,用于表示最多包含十个 MPLS 报头的数据包:
header Mpls_h {
    bit<20> label;
    bit<3>  tc;
    bit<1>  bos;
    bit<8>  ttl;
}
Mpls_h[10] mpls;
mpls.next 的类型为 Mpls_h,引用 mpls 栈中的一个元素。最初,mpls.next 引用栈的第一个元素。每当对它成功调用一次 b.extract(mpls.next),nextIndex 就 +1,从而 mpls.next 自动指向下一个槽位。属性 mpls.last 指向 nextIndex - 1 的元素(如果存在)。
边界条件:
- 当
nextIndex >= 报头栈大小时,访问mpls.next会跳转到reject,错误置为error.StackOutOfBounds。 - 当
nextIndex == 0时,访问mpls.last同样跳转到reject并置error.StackOutOfBounds。
注意:直接对某个具体下标做 b.extract(mpls[i]) 不会改变 nextIndex,只有通过 .next 提取才会推进。
下面的例子展示了一个简化的 MPLS 处理解析器:
struct Pkthdr {
    Ethernet_h ethernet;
    Mpls_h[3] mpls;
    // 其他报头省略
}

parser P(packet_in b, out Pkthdr p) {
    state start {
        b.extract(p.ethernet);
        transition select(p.ethernet.etherType) {
            0x8847: parse_mpls;
            0x0800: parse_ipv4;
        }
    }
    state parse_mpls {
        b.extract(p.mpls.next);
        transition select(p.mpls.last.bos) {
            0: parse_mpls;  // 这会形成一个循环
            1: parse_ipv4;
        }
    }
    // 其他状态省略
}
15.8 子解析器
P4 允许解析器调用其他解析器的服务。需要先实例化该子解析器。然后通过调用其 apply 方法来调用实例的服务。例如:
parser callee(packet_in packet, out IPv4 ipv4) { /* 省略主体 */ }
parser caller(packet_in packet, out Headers h) {
    callee() subparser;  // callee 的实例
    state start {
        subparser.apply(packet, h.ipv4);  // 调用子解析器
        transition accept;  // 如果子解析器以 accept 状态结束,则接受
    }
}
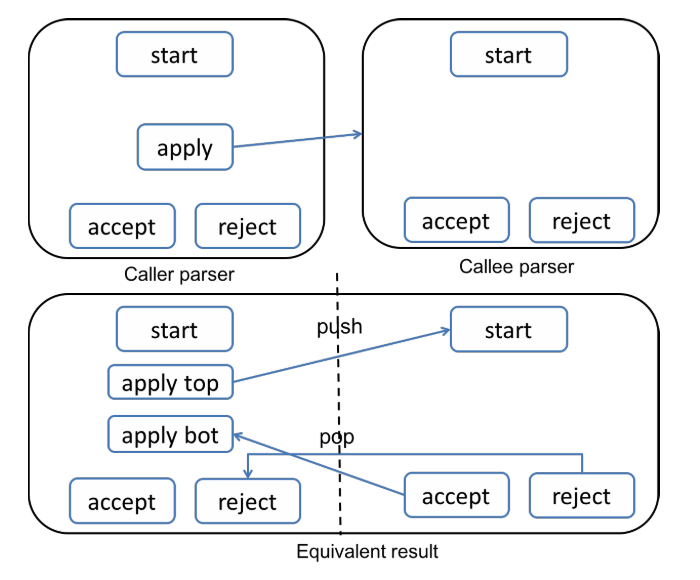
子解析器调用的语义可以描述如下:
- 调用子解析器的状态在解析器调用语句处被拆分为两个半状态。
- 顶部半状态包含对子解析器起始状态的转移。
- 子解析器的接受状态与当前状态的底部半状态对应。
- 子解析器的拒绝状态与当前解析器的拒绝状态对应。
下图展示了这一过程:
注意
P4 无法创建递归的解析器。
15.9 解析器值集
value_set 允许控制平面更新 select 的键集,适合运行期间才确定匹配值的情况。它需要在解析器的局部声明中定义,不能像表那样附带动作:
#include <core.p4>

header Protocol_h { bit<8> protocol; }

parser DynamicParser(packet_in b, out Protocol_h h) {
    value_set<bit<8>>(4) protocols;

    state start {
        b.extract(h);
        transition select(h.protocol) {
            protocols: accept;
            default: reject;
        }
    }
}
这里的 4 表示期望的集合容量。复杂匹配可以使用结构体元素,并在字段上加 @match。未指定时按 exact 匹配,具体运行时能力仍取决于控制接口和目标实现。
16 控制块
P4 解析器负责从数据包中提取数据到报头中。这些报头可以在控制块内进行操作和转换。
不能在控制块中实例化解析器。
控制块的类型接口可以有类型参数,带主体的实现声明则按 v1.2.5 §14 使用具体类型。表只能在控制块的局部声明中定义。
P4 不支持控制块内的异常控制流。对控制流有非局部影响的唯一语句是 exit,它会导致执行当前控制块立即终止。也就是说,控制块中没有等同于解析器中的 verify 语句或 reject 状态的语句。因此,所有错误处理必须显式执行。
16.1 动作
动作是可以读取和写入正在处理的数据的代码片段。动作可以包含由控制平面写入、由数据平面读取的数据值。
在语法上,动作类似于没有返回值的函数。动作可以在控制块内声明,但是这样它们只能在该控制块的实例中使用。
以下例子展示了一个动作的声明:
action Forward_a(out bit<9> outputPort, bit<9> port) {
    outputPort = port;
}
动作参数不能具有 extern 类型。没有方向的动作参数(例如,上面例子中的 port)表示“动作数据”。所有此类参数必须出现在参数列表的末尾。
动作体不能调用表、解析器或控制块。目标还可以进一步限制动作中的条件分支和可用运算。
16.1.1 调用动作
动作可以通过两种方式执行:
- 隐式调用:通过表在匹配与动作处理期间执行。
- 显式调用:可以在控制块或其他动作中进行。在这两种情况下,所有动作参数的值必须明确提供,包括无方向参数的值。
提示
无方向参数的行为类似于 in 参数。
16.2 表
表描述了一个匹配-动作单元。匹配-动作单元的结构如下图所示:
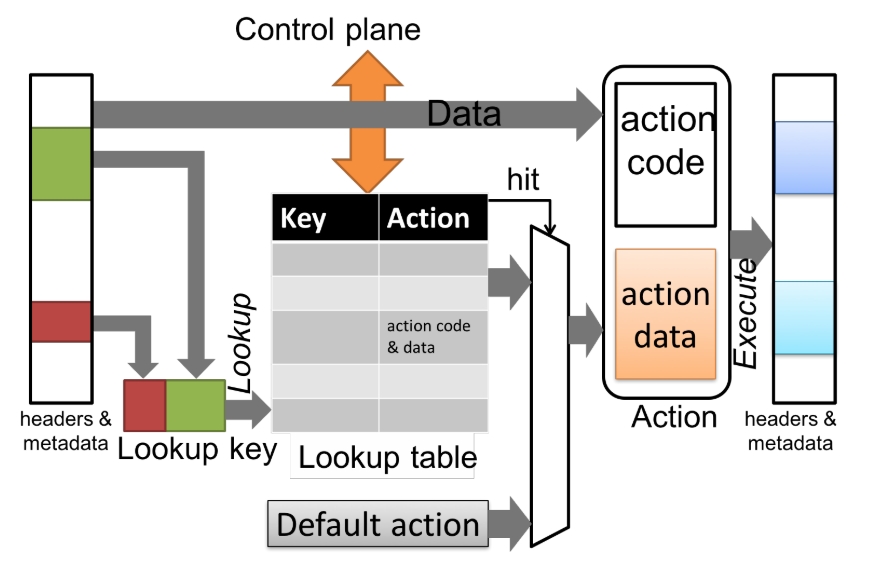
通过匹配-动作表处理数据包的步骤如下:
- 构造键。
- 在查找表中匹配键。匹配结果为一个动作。
- 执行动作,在输入数据上执行,导致数据发生变化。
查找表是一个有限映射,其内容由控制平面通过独立的控制平面API异步操作(读/写)。
标准的表属性包括:
key:一个表达式,描述了用于查找的键如何计算。actions:所有可用于表项或默认动作的动作列表,是必需属性。
此外,表还可以定义以下属性:
default_action:当查找表中的查找未能匹配键时执行的动作。size:指定表的期望大小的整数。entries:在加载P4程序时初始添加到表中的表项。largest_priority_wins:仅对包含entries属性的某些表有用。priority_delta:仅对包含entries属性的某些表有用。
对于未定义 default_action 属性的表,编译器会将其设置为 NoAction(并将其插入到动作列表中)。因此,所有表都可以被视为拥有一个隐式或显式的 default_action 属性。
被标记为 const 的属性不能由控制平面动态更改。键、动作和大小属性始终是常量,因此这些属性不需要 const 关键字。
16.2.1 表属性
16.2.1.1 键
键是一个表的属性。一个键是形如 (e : m) 的列表,其中 e 是描述要在表中匹配的数据的表达式,而 m 是描述用于执行查找的算法的 match_kind 常量。
例如,以下程序片段展示了一个键的定义:
table Fwd {
    key = {
        ipv4header.dstAddress : ternary;
        ipv4header.version    : exact;
    }
}
在这个例子中,键包含来自报头 ipv4header 的两个字段:dstAddress 和 version。match_kind 常量指定在运行时如何匹配数据平面值与表中的表项。
P4 核心库包含三个预定义的 match_kind 标识符:
match_kind {
    exact,
    ternary,
    lpm
}
三种匹配标识符的含义如下:
exact:键字段的值必须精确匹配表中的字段值。ternary:键字段使用值和掩码(value, mask)来匹配,遵循 P4 的掩码表达式语义。lpm(longest prefix match):最长前缀匹配,是ternary的一种特殊形式,掩码必须形如连续的 1 后接连续的 0(即前缀掩码1^k 0^(W-k),不允许中间夹 0 或 1)。
某些表项(尤其是包含 ternary 字段的表项)还需要优先级值。当键属于多个集合时,优先级高的表项会被首先匹配。
如果表没有 key 属性,或者写成空键列表 key = {},那么该表不包含查找表,调用时总是执行默认动作,hit 为 false、miss 为 true。这样的表不能声明 entries。
16.2.1.2 动作
表必须声明可能出现在关联查找表中或默认动作的所有可能的动作,这通过 actions 属性来实现。例如:
action Drop_action() {
    outCtrl.outputPort = DROP_PORT;
}

action Rewrite_smac(EthernetAddress sourceMac) {
    headers.ethernet.srcAddr = sourceMac;
}

table smac {
    key = { outCtrl.outputPort : exact; }
    actions = {
        Drop_action;
        Rewrite_smac;
    }
}- 在
smac表中的表项可能包含两种不同的动作:Drop_action和Rewrite_smac。 Rewrite_smac动作有一个参数sourceMac,在这种情况下,它将由控制平面提供。
表中的每个动作在动作列表中必须有一个唯一的名称。例如,下面例子就是错误的:
action a() {}
control c() {
    action a() {}
    // 非法表:有两个名称相同的动作
    table t { actions = { a; .a; } }
}每个有方向(in、inout 或 out)的动作参数必须在动作列表中绑定。相反,没有方向的参数不能绑定在列表中。应用表(无论是通过 table1.apply().hit 这样的表达式直接调用,还是间接调用)在作为动作参数的表达式中是被禁止的。例如:
action a(in bit<32> x) { /* 省略主体 */ }
bit<32> z;
action b(inout bit<32> x, bit<8> data) { /* 省略主体 */ }
table t {
    actions = {
        a;        // 错误,a 的参数 x 必须被绑定
        a(5);     // 将 a 的参数 x 绑定为 5
        b(z);     // 将 b 的参数 x 绑定为 z
        b(z, 3);  // 错误,不能绑定无方向的 data 参数
        b();      // 错误,b 的 x 参数必须被绑定
        a(table2.apply().hit ? 5 : 3);  // 错误,不能在这里应用表
    }
}
16.2.1.3 默认动作
如果需要设置默认动作 default action,则必须写在 actions 属性之后。它可以被声明为 const,表示它不能由控制平面动态更改。默认动作必须是 actions 列表中出现的动作之一。传递给 in、out 或 inout 参数的表达式必须与 actions 列表中的某个元素使用的表达式在语法上完全相同。
无方向参数必须在默认动作中绑定为编译时已知值,有方向参数的实参则在动作执行时求值。const entries 只限制普通表项,并不自动把默认动作设为常量。
例如,在上节的表中,我们设置如下默认动作(同时标记为常量):
const default_action = Rewrite_smac(48w0xAA_BB_CC_DD_EE_FF);继续上节的例子,以下是表 t 的一些默认动作:
default_action = a(5);
default_action = a(z);      // 错误,a 的 x 参数在动作列表中已经绑定到 5
default_action = b(z,8w8);  // 将 b 的 data 参数绑定到 8w8
default_action = b(z);      // 错误,b 的 data 参数没有绑定
default_action = b(x, 3);   // 错误,actions 列表里 b 的 x 参数已经绑定到 z,这里传 x 不匹配
16.2.1.4 表项(Entries)
表项通常由控制平面安装,但也可以在编译时用一组表项初始化表。
使用 const entries 声明静态定义表项在实现固定算法的时候非常有用,编译器能够推断出表的实际用途,并有可能对资源做出更好的分配决策。
用 const entries 定义的表项是不可变的。控制平面只能读取它们,不能移除或修改任何表项,也不允许向这样的表中添加表项。
使用 entries(没有 const 修饰符)定义的表项可以在单个表项前加上 const。带有 const 的表项不能被控制平面修改或移除。没有 const 的表项可以由控制平面修改或移除。与使用 const entries 声明的表不同,控制平面可以向这样的表中添加表项(受表容量限制)。
当运行时 API 要求数值优先级,且源码没有显式指定优先级时,编译器分配优先级,使靠前的初始表项先匹配。例如,P4Runtime 中含三元匹配的表属于这种情况。不能把源码顺序当作所有表的统一匹配规则,最长前缀匹配仍选择最长前缀。
根据键的 match_kind,键集表达式可以定义一个或多个表项。
示例:
header hdr {
    bit<8>  e;
    bit<16> t;
    bit<8>  l;
    bit<8>  r;
    bit<1>  v;
}

struct Header_t {
    hdr h;
}
struct Meta_t {}

control ingress(inout Header_t h, out bit<9> outputPort) {

    action a() { outputPort = 0; }
    action a_params(bit<9> x) { outputPort = x; }

    table t_exact_ternary {

        key = {
            h.h.e : exact;
            h.h.t : ternary;
        }

        actions = {
            a;
            a_params;
        }

        default_action = a;

        const entries = {
            (0x01, 0x0001 &&& 0x000F) : a_params(1);
            (0x02, 0x1181           ) : a_params(2);
            (0x03, 0x1000 &&& 0xF000) : a_params(3);
            (0x04, 0x0210 &&& 0x02F0) : a_params(4);
            (0x04, 0x0010 &&& 0x02F0) : a_params(5);
            (0x06, _                ) : a_params(6);
            (_, _)                   : a;
        }
    }

    apply {
        t_exact_ternary.apply();
    }
}
这里定义了 7 个初始表项,最后一个通配表项调用 a。表有三元匹配键且没有显式指定优先级,因此靠前的项优先。此例的 outputPort 是普通输出参数,它表示什么端口、如何用于转发,要由调用它的架构决定。
16.2.1.4.1 表项优先级(Entry priorities)
如果表的匹配字段都是 exact(精确匹配)或 lpm(最长前缀匹配),那么没有必要为其表项分配数值优先级。如果所有匹配字段都是精确匹配,则不允许存在重复的键,因此每次查找最多只能匹配一个表项,所以不需要设置优先级。如果存在 lpm 字段,则表项的优先级与前缀的长度相关。
对于相同的查找键可以同时匹配表中的多个表项的情况,控制平面 API 要求控制平面软件在向这样的表添加每个表项时提供一个数值优先级。这样,数据平面就可以确定哪个匹配表项是“赢家”。
数值优先级有两种常用但不同的方式:
- P4Runtime:需要优先级的表使用正整数,数值越大越优先。
- TDI:优先级使用非负整数,数值越小越优先。
largest_priority_wins 是 bool 类型的表属性,用于解释源码中初始表项的优先级。true 表示较大数值优先,false 表示较小数值优先。它不能修改所用控制接口的规则,也不存在名为 smallest_priority_wins 的标准表属性。
默认优先级属性
如果不指定 largest_priority_wins 属性,默认为 true,对应 largest_priority_wins。
priority_delta 必须是编译时已知的正整数,默认为 1,用于自动分配优先级时的间隔。若没有任何显式优先级,编译器从 1 开始,按较大或较小数值优先的约定分配,保证源码靠前的表项优先。若至少一项显式指定了优先级,第一项也必须显式指定,其后的未指定项从前一项按 priority_delta 递增或递减。
以下定义可以替换上一例中的 t_exact_ternary:
table t_exact_ternary {
    key = {
        h.h.e : exact;
        h.h.t : ternary;
    }

    actions = {
        a;
        a_params;
    }

    default_action = a;

    largest_priority_wins = false;
    priority_delta = 10;
    @noWarn("duplicate_priorities")
    entries = {
        const priority=10: (0x01, 0x0001 &&& 0x000F) : a_params(1);
                           (0x02, 0x1181           ) : a_params(2);  // priority=20
                           (0x03, 0x1000 &&& 0xF000) : a_params(3);  // priority=30
        const              (0x04, 0x0210 &&& 0x02F0) : a_params(4);  // priority=40
              priority=40: (0x04, 0x0010 &&& 0x02F0) : a_params(5);
                           (0x06, _                ) : a_params(6);  // priority=50
    }
}
没有显式指定优先级的表项将被分配如注释中所示的优先级值。通常,此程序会发出多个表项具有相同优先级 40 的警告,但由于使用了 @noWarn("duplicate_priorities") 注解,这些警告将被抑制。
若多个重叠表项具有相同的最高优先级,不能依赖其中哪一项胜出。抑制警告不会消除这种不确定性。使用 P4Runtime 时,实际写入的表项仍必须遵守其较大优先级胜出的规则。
16.2.1.5 大小(Size)
size 是可选属性,必须是编译时已知的整数,以表项数为单位描述期望容量。它不表示当前已经安装了多少项,也不保证任意组合的这么多项都能插入。哈希冲突、目标资源分配等因素可能限制实际可用容量,某些目标还要求显式提供 size。
16.2.2 表的调用
可以通过调用表的 apply 方法来调用表。调用表实例上的 apply 方法会返回一个包含三个字段的结构体类型的值。对于每个表 T,编译器生成一个枚举和一个结构,伪代码如下所示:
enum action_list(T) {
    // 每个字段对应表 T 的动作列表中的一个动作
}

struct apply_result(T) {
    bool hit;
    bool miss;
    action_list(T) action_run;
}
apply 方法会在查找表中匹配成功时将 hit 字段设置为 true,并将 miss 字段设置为 false。如果未找到匹配,hit 会被设置为 false,而 miss 会被设置为 true。这些位可以用于调整控制块中的代码执行:
if (ipv4_match.apply().hit) {
    // 有命中
} else {
    // 未命中
}

if (ipv4_host.apply().miss) {
    ipv4_lpm.apply(); // 只有在主机表未命中时才查找路由
}
action_run 字段表示执行了哪种类型的动作(无论是命中还是未命中)。它可以用于 switch 语句:
switch (dmac.apply().action_run) {
    Drop_action: { return; }
}
16.2.3 表调用的原理
m.apply() 的原理如下方伪代码所示:
apply_result(m) m.apply() {
    apply_result(m) result;

    var lookupKey = m.buildKey(m.key);
    action RA = m.table.lookup(lookupKey);
    if (RA == null) {  // 查找表未命中
        result.hit = false;
        RA = m.default_action;  // 使用默认动作
    } else {
        result.hit = true;
    }
    result.miss = !result.hit;
    result.action_run = action_type(RA);
    evaluate_and_copy_in_RA_args(RA);
    execute(RA);
    copy_out_RA_args(RA);
    return result;
}
伪代码中 buildKey 的作用是按照键定义的顺序依次计算每个键表达式。
17 参数化
解析器 parser 和控制块 control 都可以通过构造函数参数进行额外的参数化。
构造函数参数必须是无方向的(即不能是 in、out 或 inout)。
示例:
parser GenericParser(packet_in b, out Packet_header p)
                    (bool udpSupport) {  // 构造函数参数
    state start {
        b.extract(p.ethernet);
        transition select(p.ethernet.etherType) {
            16w0x0800: ipv4;
        }
    }
    state ipv4 {
        b.extract(p.ipv4);
        transition select(p.ipv4.protocol) {
            6: tcp;
            17: tryudp;
        }
    }
    state tryudp {
        transition select(udpSupport) {
            false: accept;
            true : udp;
        }
    }
    state udp {
        // 省略主体
    }
}
在实例化 GenericParser 时,必须为 udpSupport 参数提供一个值,例如:
// topParser 是一个 GenericParser 实例,其中 udpSupport = false
GenericParser(false) topParser;
17.1 直接调用
控制块和解析器通常被实例化一次。作为一种轻量级的语法糖,没有构造参数的控制块 control 和解析器 parser 可以直接调用,仿佛它们就是一个实例。这会导致创建并调用该类型的局部实例。例如:
control Callee(/* 参数省略 */) { /* 主体省略 */ }

control Caller(/* 参数省略 */)(/* 参数省略 */) {
    apply {
        Callee.apply(/* 参数省略 */);  // Callee 被视为一个实例
    }
}
Caller 的定义等价于以下内容:
control Caller(/* 参数省略 */)(/* 参数省略 */) {
    @name("Callee") Callee() Callee_inst;  // Callee 的局部实例
    apply {
        Callee_inst.apply(/* 参数省略 */);  // Callee_inst 被调用
    }
}
此特性用于简化类型只被实例化一次的情况。规范中泛型直接调用示例与泛型实现限制的矛盾,见第 15.2 节。
多次对同一类型直接调用,实例归属规则如下:
- 同一作用域内,每次直接调用创建不同的局部实例,但同类型实例经隐式
@name获得相同的控制平面名称。若类型包含表等可控实体,多次直接调用会造成名称冲突,属于非法程序。 - 不同作用域内的直接调用创建不同实例,其完全限定控制平面名称也不同。
以上是规范 §15.1 的规则。需要复用实例时,应显式声明 Foo() foo;,再多次调用 foo.apply()。
对于需要构造参数的控制块或解析器,不能进行直接调用,必须在调用之前手动实例化。
18 反解析
解析的逆过程是反解析或构造数据包,P4 没提供单独的反解析语法,需要在带有参数类型 packet_out 的控制块中完成。
例如,下面的例子先在 packet_out 写入以太网报头,然后写入 IPv4 报头:
control TopDeparser(inout Parsed_packet p, packet_out b) {
    apply {
        b.emit(p.ethernet);
        b.emit(p.ip);
    }
}
18.1 往数据包插入数据
数据类型 packet_out 在 P4 核心库中定义,以下是其定义的内容。它提供了一个名为 emit 的方法,用于将数据附加到输出数据包:
extern packet_out {
    void emit<T>(in T data);
}
emit 方法支持将报头 header、报头栈、结构体 struct 或报头联合体 header_union 中的数据附加到输出数据包中。
- 应用于报头:报头有效时按声明顺序写入字段,无效时跳过。
- 应用于报头栈:按索引顺序递归调用
emit,无效元素跳过。 - 应用于结构体或报头联合体:递归地对每个字段调用
emit。
可序列化约束
emit 的直接参数必须是报头、报头栈、报头联合体,或递归包含这些类型的结构体。不能直接写 b.emit(8w1),也不能把任意元数据结构体当作可输出报文。
报头内部的字段按其声明的位表示输出,包括固定宽度整数、布尔值、可序列化枚举及 varbit 的当前宽度。普通 enum、error 和 string 等不符合报头字段约束。
下方伪代码展示了 emit 方法的原理:
packet_out {
    byte[] data;
    unsigned lengthInBits;
    void initializeForWriting() {
        this.data.clear();
        this.lengthInBits = 0;
    }
    // 将数据追加到数据包中。类型 T 必须是报头、报头栈、报头联合体,或者由这些类型组成的结构体
    void emit<T>(T data) {
        if (isHeader(T)) {
            if (data.valid$) {
                this.data.append(data);
                this.lengthInBits += data.lengthInBits;
            }
        } else if (isHeaderStack(T)) {
            for (e : data)
                emit(e);
        } else if (isHeaderUnion(T) || isStruct(T)) {
            for (f : data.fields$)
                emit(data.f);
        }
        // 其他 T 类型的情况是非法的
    }
}其中,valid$ 标识符表示报头的隐藏有效位,fields$ 表示结构体或报头联合体的字段列表。使用 for-each 语法来遍历栈中的元素(e : data)以及遍历结构体和报头联合体的字段列表(f : data.fields$)。对于结构体的迭代顺序是按照类型声明中字段的顺序进行的。
19 架构描述
架构描述形式为一个 P4 源文件,该文件至少有一个包 package 的声明。
该文件可能预定义数据类型、常量、错误,还需声明所有可编程模块的类型,包括解析器和控制块。这些模块可以选择性地组合到包中,包也可以嵌套。
19.1 架构描述示例
以下示例描述具有入口和出口两条处理流水线的交换机。每条流水线包含解析器、匹配与动作处理、反解析器:
parser Parser<IH>(packet_in b, out IH parsedHeaders);
// ingress match-action pipeline
control IPipe<T, IH, OH>(in IH inputHeaders,
                         in InControl inCtrl,
                         out OH outputHeaders,
                         out T toEgress,
                         out OutControl outCtrl);
// egress match-action pipeline
control EPipe<T, IH, OH>(in IH inputHeaders,
                         in InControl inCtrl,
                         in T fromIngress,
                         out OH outputHeaders,
                         out OutControl outCtrl);
control Deparser<OH>(in OH outputHeaders, packet_out b);
package Ingress<T, IH, OH>(Parser<IH> p,
                           IPipe<T, IH, OH> map,
                           Deparser<OH> d);
package Egress<T, IH, OH>(Parser<IH> p,
                          EPipe<T, IH, OH> map,
                          Deparser<OH> d);
package Switch<T>(Ingress<T, _, _> ingress, Egress<T, _, _> egress);
19.2 架构程序示例
完整程序需要在顶层实例化架构包,并将实例命名为 main。必须为必需参数提供类型匹配的实参,带默认值或 @optional 的参数可以按各自规则省略。main 是包实例,不是普通变量。
例如,给出以下类型声明:
parser Prs<T>(packet_in b, out T result);
control Pipe<T>(in T data);
package Switch<T>(Prs<T> p, Pipe<T> map);
以及以下声明:
parser P(packet_in b, out bit<32> index) { /* 省略主体 */ }
control Pipe1(in bit<32> data) { /* 省略主体 */ }
control Pipe2(in bit<8> data) { /* 省略主体 */ }
合法的顶层 main 包实例声明:
Switch(P(), Pipe1()) main;以下声明是非法的:
Switch(P(), Pipe2()) main;后者的声明不正确,因为解析器 P 需要 T 为 bit<32>,而 Pipe2 需要 T 为 bit<8>。
我们也可以显式地为类型变量指定值(否则编译器需要推断这些类型变量的值):
Switch<bit<32>>(P(), Pipe1()) main;20 静态断言
P4 核心库包含两个 static_assert 函数的重载声明,定义如下:
extern bool static_assert(bool check, string message);
在编译时计算表达式check。如果表达式为false,停止编译并打印相应消息。extern bool static_assert(bool check);
同上,但使用默认消息。
示例:
#include <core.p4>
#include <v1model.p4>

const bool _check = static_assert(V1MODEL_VERSION > 20180000,
                                  "Expected V1MODEL_VERSION > 20180000");
如果 static_assert 返回 false,将导致程序编译立即终止并报错。
21 注解
注解是一种简单的机制,能够在不改变语法的情况下扩展 P4 语言。注解通过 @ 符号添加到类型、字段、变量上。非结构化注解有一个可选主体,而结构化注解有一个强制主体,至少包含一对方括号 []。
同一元素上的非结构化注解和结构化注解的名称不能相同。
正确示例:
@MyAnno(1) table T { /* 省略主体 */ }
@MyAnno[2] table U { /* 省略主体 */ }  // OK,虽然注解名相同,但是在不同对象上
错误示例:
@MyAnno(1)
@MyAnno[2] table U { /* 省略主体 */ } // Error,非结构化注解和结构化注解的不能同名同一元素上的非结构化注解可以有相同名称。
同一元素上的结构化注解不能有相同名称。
正确示例:
@MyAnno(1)
@MyAnno(2) table U { /* 省略主体 */ }  // OK,同一元素上的非结构化注解名称可以相同
错误示例:
@MyAnno[1]
@MyAnno[2] table U { /* 省略主体 */ }  // Error,同一元素上的结构化注解名称不能相同
21.1 非结构化注解的主体
@MyAnno(注解主体)
21.2 结构化注解的主体
@MyAnno[注解主体]
21.2.1 结构化注解示例
注解的主体列表为空:
@Empty[]
table t {
    /* 省略主体 */
}
注解的主体列表包含多种类型:
#define TEXT_CONST "hello"
#define NUM_CONST 6
@MixedExprList[1,TEXT_CONST,true,1==2,5+NUM_CONST]
table t {
    /* 省略主体 */
}
注解的主体列表为键值对列表:
@Labels[short="Short Label", hover="My Longer Table Label to appear in hover-help"]
table t {
    /* 省略主体 */
}
注解的主体列表为键值对列表,且包含多种类型:
@MixedKV[label="text", my_bool=true, int_val=2*3]
table t {
    /* 省略主体 */
}
不允许混合键值对与表达式列表:
@IllegalMixing[key=4, 5]  // Error
table t {
    /* 省略主体 */
}
不允许键名相同:
@DupKey[k1=4,k1=5]  // Error,有两个键都叫 k1
table t {
    /* 省略主体 */
}
不允许结构化注解名称相同:
@DupAnno[k1=4]
@DupAnno[k2=5]  // Error,有两个结构化注解名称都叫 DupAnno
table t {
    /* 省略主体 */
}
不允许结构化注解和非结构化注解使用相同名称:
@MixAnno("Anything")
@MixAnno[k2=5]  // Error,和上一行的非结构化的注解同名
table t {
    /* 省略主体 */
}
21.3 预定义注解
以小写字母开头的注解名称保留给了标准库和架构。下表显示了所有 P4 保留注解:
| 注解名称 | 作用 |
|---|---|
atomic | 指定原子执行 |
defaultonly | 动作只能出现在默认动作中 |
hidden | 从控制平面隐藏可控实体 |
match | 指定 value_set 中字段的 match_kind |
name | 指定本地控制平面名称 |
optional | 参数可选 |
tableonly | 动作不能是默认动作 |
deprecated | 构造已被弃用 |
pure | 外部调用只依赖输入参数,不读写隐藏状态 |
noSideEffects | 外部调用不修改隐藏状态,但可以读取隐藏状态 |
noWarn | 具有字符串参数。抑制编译器警告 |
21.3.1 可选参数注解
@optional 用于包参数、解析器和控制块类型的参数,以及外部函数、外部方法和外部对象构造函数的参数。它不只用于构造函数。不能与参数默认值同时使用,省略后的行为由目标架构定义。
21.3.2 表动作列表上的注解
以下两个注解可用于向编译器和控制平面提供有关表中动作的附加信息。这些注解没有主体。
@tableonly:限制该表中此动作只能用于普通表项,不能作为默认动作。@defaultonly:限制该表中此动作只能用于默认动作,不能用于普通表项。
这两个注解加在 actions 列表的动作引用上,限制的是该表中的用途。
table t {
    actions = {
        a;               // 可用于普通表项或默认动作
        @tableonly b;    // 只能用于普通表项
        @defaultonly c;  // 只能用于默认动作
    }
    /* 省略主体 */
}
21.3.3 控制平面API注解
@name 注解指示编译器在生成操纵控制平面元素的外部 API 时使用不同的名称。该注解采用字符串字面量主体。在以下示例中,表的完全限定名称为 c_inst.t1:
control c( /* 参数省略 */ )() {
    @name("t1") table t { /* 主体省略 */ }
    apply { /* 主体省略 */ }
}
c() c_inst;
@hidden 注解将可控实体(例如表、键、动作或外部)隐藏在控制平面中。有效地移除了它的完全限定名称。此注解没有主体。
21.3.3.1 限制
每个元素至多使用一个 @name 或 @hidden 注解。每个控制平面名称至多引用一个可控实体。如果某类型内部的可控实体使用绝对 @name 名称,即字符串以点开头,实例化该类型多次就可能使名称冲突。例如:
control noargs();
package top(noargs c1, noargs c2);

control c() {
    @name(".foo.bar") table t { /* 主体省略 */ }
    apply { /* 主体省略 */ }
}
top(c(), c()) main;
如果没有 @name 注解,这个程序将生成两个具有完全限定名称的可控实体 main.c1.t 和 main.c2.t。然而,@name(".foo.bar") 注解将这两个实例中的表 t 重命名为 foo.bar,导致同一个名称引用两个可控实体,这是非法的。
完全限定名称
完全限定名称(Fully Qualified Name)是指在编程中用来唯一标识某个元素的名称,包括其所在的所有作用域或上下文信息。在 P4 语言中,完全限定名称通常由多个部分组成,如包名、控制块名、表名等,确保在同一程序中不同元素不会产生名称冲突。例如,main.c1.t 表示 c1 控制块中的表 t,位于 main 包中。
21.3.4 并发控制注解
对同一个 extern 实例的一次方法调用必须原子执行,但多次调用之间不自动构成一个原子操作。例如寄存器的读取、修改、写回可能被其他数据包的操作插入,需要用 @atomic 包围整个过程。
@atomic 可以用于块语句、解析器状态、控制块或整个解析器。若目标无法实现所要求的原子执行,编译器必须拒绝程序,不能直接忽略注解。参见规范 §18.4.1。
21.3.5 值集注解
注解 @match 用于指定 value_set 字段的 match_kind 值,而不是默认值 exact。
21.3.6 外部函数与方法注解
@pure 表示调用只依赖 in 参数,不读取或修改隐藏状态。@noSideEffects 表示不修改隐藏状态,但结果可以依赖它,例如读取寄存器。两者仍允许通过返回值和 out、inout 参数提供结果,不能简单理解为完全不写任何数据。
这些声明帮助编译器判断调用是否可以删除、合并或重排,应与架构实现的实际行为一致。
21.3.7 弃用注解
注解 @deprecated 有一个必需的字符串参数,当程序使用被弃用的构造时,将由编译器打印该字符串。例如:
@deprecated("Please use the 'check' function instead")
extern Checker {
    /* 省略主体 */
}
21.3.8 无警告注解
注解 @noWarn 有一个必需的字符串参数,该参数表示将被抑制的编译器警告。例如,在声明上使用 @noWarn("unused") 将防止编译器在该声明未被使用的情况下发出警告。
22 例子:一个非常简单的交换机
规范 §5 提供了教学架构“非常简单的交换机”(Very Simple Switch),简称 VSS。它用于说明语言与架构如何配合,不是 BMv2 的 v1model,不能直接用 p4c-bm2-ss 编译为 simple_switch 的配置。
22.1 VSS 架构
该架构的示意图如下所示:
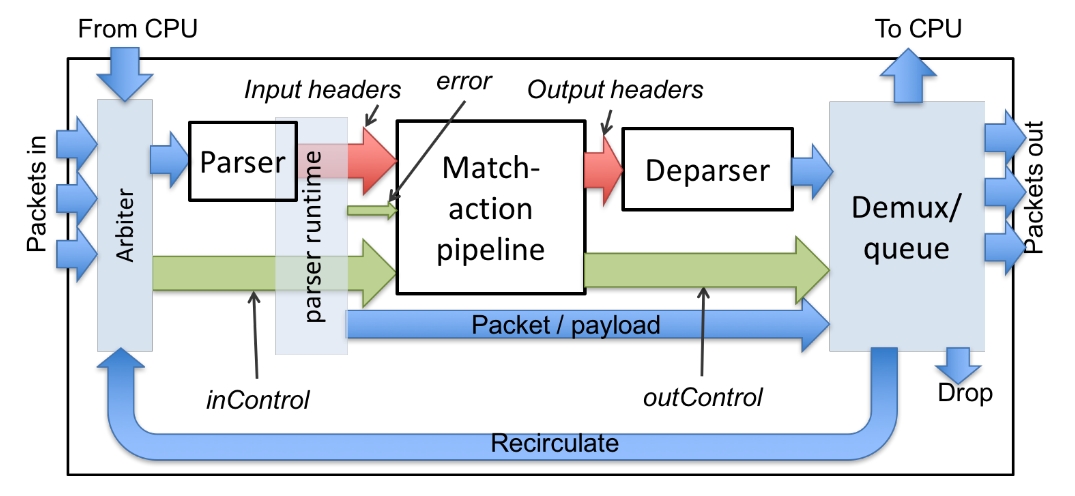
VSS 通过 8 个输入以太网端口、循环通道或直接连接到 CPU 的端口接收数据包。VSS 具有一个解析器,连接到单个匹配-动作流水线,再到单个反解析器。数据包经过反解析器后,通过 8 个输出以太网端口或 3 个“特殊”端口发出:CPU 端口(发送到控制平面)、Drop 端口(丢弃数据包)和 Recirculate 端口(通过特殊输入端口重新注入交换机)。白色块为可编程,需提供 P4 程序指定其行为。
下面是 P4 官方提供的 VSS 的声明:
// File "very_simple_switch_model.p4"
// Very Simple Switch P4 declaration

#include <core.p4>

/* Various constants and structure declarations */
typedef bit<4> PortId;  // Ports are represented using 4-bit values
const PortId REAL_PORT_COUNT = 4w8;  // Number of real ports (8)

/* Metadata accompanying an input packet */
struct InControl {
    PortId inputPort;
};

/* Special input port values */
const PortId RECIRCULATE_IN_PORT = 0xD;
const PortId CPU_IN_PORT = 0xE;

/* Metadata that must be computed for outgoing packets */
struct OutControl {
    PortId outputPort;
};

/* Special output port values for outgoing packet */
const PortId DROP_PORT = 0xF;
const PortId CPU_OUT_PORT = 0xE;
const PortId RECIRCULATE_OUT_PORT = 0xD;

/* Prototypes for all programmable blocks */

/**
 * Programmable parser.
 * @param <H> type of headers; defined by user
 * @param b input packet
 * @param parsedHeaders headers constructed by parser
 */
parser Parser<H>(packet_in b,
                 out H parsedHeaders);

/**
 * Match-action pipeline
 * @param <H> type of input and output headers
 * @param headers headers received from the parser and sent to the deparser
 * @param parseError error that may have surfaced during parsing
 * @param inCtrl information from architecture, accompanying input packet
 * @param outCtrl information for architecture, accompanying output packet
 */
control Pipe<H>(inout H headers,
                in error parseError,
                in InControl inCtrl,
                out OutControl outCtrl);

/**
 * VSS deparser.
 * @param <H> type of headers; defined by user
 * @param b output packet
 * @param outputHeaders headers for output packet
 */
control Deparser<H>(inout H outputHeaders,
                    packet_out b);

/**
 * Top-level package declaration - must be instantiated by user.
 * @param <H> user-defined type of the headers processed.
 */
package VSS<H>(Parser<H> p,
               Pipe<H> map,
               Deparser<H> d);

// Architecture-specific objects that can be instantiated

// Checksum unit
extern Checksum16 {
    Checksum16();  // Constructor
    void clear();  // Prepare unit for computation
    void update<T>(in T data);  // Add data to checksum
    void remove<T>(in T data);  // Remove data from existing checksum
    bit<16> get();  // Get the checksum for the data added since last clear
}
22.2 VSS 完整程序
下面的程序依据规范示例整理,实现基本 IPv4 转发。这里把动作列表改为分号分隔,给 check_ttl 增加固定的零值匹配项,并在递减前处理初始 TTL 为 0 的情况,避免 8 位无符号数回绕到 255。
解析器提取以太网和 IPv4 报头,并校验 IPv4 版本、IHL 和校验和。非 IPv4 报文、数据不足、带 IPv4 选项或校验失败都会拒绝解析,后续控制块根据解析错误丢包。
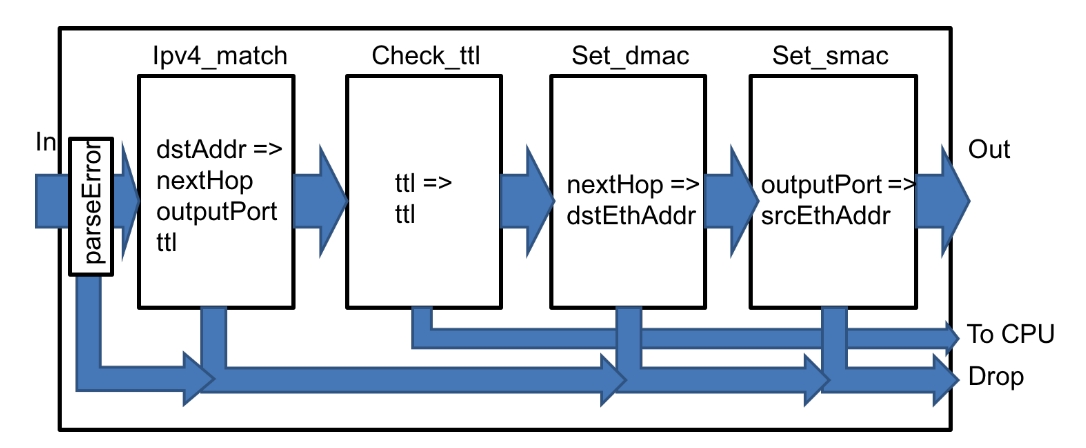
匹配-动作流程如上图所示。它包括四个匹配-动作单元:
- 第一个表使用 IPv4 目标地址来确定输出端口和下一跳的 IPv4 地址。如果查找失败,则丢弃数据包。该表递减 IPv4
ttl值。 - 第二个表检查
ttl值:如果ttl变为 0,则通过 CPU 端口将数据包发送到控制平面。 - 第三个表使用下一跳的 IPv4 地址(由第一个表计算)来确定下一跳的以太网地址。
- 最后,最后一个表使用
outputPort标识当前交换机的源以太网地址,该地址在传出数据包中设置。
反解析器会在输出前重新计算 IPv4 报头校验和。ipv4_match、dmac 和 smac 仍需由控制平面填入表项,否则默认动作会丢包。CPU 收包后的 ICMP 处理、ARP 和端口管理不在这个示例中。
可以用 p4test --std p4-16 --validate docs/sdn/codes/vss.p4 检查语言层面的合法性。这个检查不验证目标资源分配或实际转发行为。
完整代码如下:
// Include P4 core library
#include <core.p4>

// Include very simple switch architecture declarations
#include "very_simple_switch_model.p4"

// This program processes packets comprising an Ethernet and an IPv4
// header, and it forwards packets using the destination IP address

typedef bit<48> EthernetAddress;
typedef bit<32> IPv4Address;

// Standard Ethernet header
header Ethernet_h {
    EthernetAddress dstAddr;
    EthernetAddress srcAddr;
    bit<16>         etherType;
}

// IPv4 header (without options)
header IPv4_h {
    bit<4>      version;
    bit<4>      ihl;
    bit<8>      diffserv;
    bit<16>     totalLen;
    bit<16>     identification;
    bit<3>      flags;
    bit<13>     fragOffset;
    bit<8>      ttl;
    bit<8>      protocol;
    bit<16>     hdrChecksum;
    IPv4Address srcAddr;
    IPv4Address dstAddr;
}

// Structure of parsed headers
struct Parsed_packet {
    Ethernet_h ethernet;
    IPv4_h     ip;
}

// User-defined errors that may be signaled during parsing
error {
    IPv4OptionsNotSupported,
    IPv4IncorrectVersion,
    IPv4ChecksumError
}

// Parser section
parser TopParser(packet_in b, out Parsed_packet p) {
    Checksum16() ck;  // Instantiate checksum unit

    state start {
        b.extract(p.ethernet);
        transition select(p.ethernet.etherType) {
            0x0800: parse_ipv4; // IPv4 packets
            // No default rule: all other packets rejected
        }
    }

    state parse_ipv4 {
        b.extract(p.ip);
        verify(p.ip.version == 4w4, error.IPv4IncorrectVersion);
        verify(p.ip.ihl == 4w5, error.IPv4OptionsNotSupported);
        ck.clear();
        ck.update(p.ip);
        // Verify that packet checksum is zero
        verify(ck.get() == 16w0, error.IPv4ChecksumError);
        transition accept;
    }
}

// Match-action pipeline section
control TopPipe(inout Parsed_packet headers,
                in error parseError,  // Parser error
                in InControl inCtrl,  // Input port
                out OutControl outCtrl) {

    IPv4Address nextHop = 0;  // Local variable

    /**
     * Indicates that a packet is dropped by setting the
     * output port to the DROP_PORT
     */
    action Drop_action() {
        outCtrl.outputPort = DROP_PORT;
    }

    /**
     * Set the next hop and the output port.
     * Decrements ipv4 ttl field.
     * @param ipv4_dest ipv4 address of next hop
     * @param port output port
     */
    action Set_nhop(IPv4Address ipv4_dest, PortId port) {
        nextHop = ipv4_dest;
        headers.ip.ttl = headers.ip.ttl - 1;
        outCtrl.outputPort = port;
    }

    /**
     * Computes address of next IPv4 hop and output port
     * based on the IPv4 destination of the current packet.
     * Decrements packet IPv4 TTL.
     * @param nextHop IPv4 address of next hop
     */
    table ipv4_match {
        key = { headers.ip.dstAddr: lpm; }  // Longest-prefix match
        actions = {
            Drop_action;
            Set_nhop;
        }
        size = 1024;
        default_action = Drop_action;
    }

    /**
     * Send the packet to the CPU port
     */
    action Send_to_cpu() {
        outCtrl.outputPort = CPU_OUT_PORT;
    }

    /**
     * Check packet TTL and send to CPU if expired.
     */
    table check_ttl {
        key = { headers.ip.ttl: exact; }
        actions = { Send_to_cpu; NoAction; }
        const default_action = NoAction; // Defined in core.p4
        const entries = {
            0: Send_to_cpu();
        }
    }

    /**
     * Set the destination MAC address of the packet
     * @param dmac destination MAC address.
     */
    action Set_dmac(EthernetAddress dmac) {
        headers.ethernet.dstAddr = dmac;
    }

    /**
     * Set the destination Ethernet address of the packet
     * based on the next hop IP address.
     * @param nextHop IPv4 address of next hop.
     */
    table dmac {
        key = { nextHop: exact; }
        actions = {
            Drop_action;
            Set_dmac;
        }
        size = 1024;
        default_action = Drop_action;
    }

    /**
     * Set the source MAC address.
     * @param smac: source MAC address to use
     */
    action Set_smac(EthernetAddress smac) {
        headers.ethernet.srcAddr = smac;
    }

    /**
     * Set the source mac address based on the output port.
     */
    table smac {
        key = { outCtrl.outputPort: exact; }
        actions = {
            Drop_action;
            Set_smac;
        }
        size = 16;
        default_action = Drop_action;
    }

    apply {
        if (parseError != error.NoError) {
            Drop_action();  // Invoke drop directly
            return;
        }
        // Guard against 8-bit TTL underflow before Set_nhop decrements it.
        if (headers.ip.ttl == 0) {
            Send_to_cpu();
            return;
        }
        ipv4_match.apply();  // Match result will go into nextHop
        if (outCtrl.outputPort == DROP_PORT) return;
        check_ttl.apply();
        if (outCtrl.outputPort == CPU_OUT_PORT) return;
        dmac.apply();
        if (outCtrl.outputPort == DROP_PORT) return;
        smac.apply();
    }
}

// Deparser section
control TopDeparser(inout Parsed_packet p, packet_out b) {
    Checksum16() ck;

    apply {
        b.emit(p.ethernet);
        if (p.ip.isValid()) {
            ck.clear();               // Prepare checksum unit
            p.ip.hdrChecksum = 16w0;  // Clear checksum
            ck.update(p.ip);          // Compute new checksum
            p.ip.hdrChecksum = ck.get();
        }
        b.emit(p.ip);
    }
}

// Instantiate the top-level VSS package
VSS(
    TopParser(),
    TopPipe(),
    TopDeparser()
) main;